
TokenWing开源:12GB显存跑124B大模型
🆕 昨天我报道了 Strata 脱离 llama.cpp 和 Hugging Face,用一个极小的 LoRA 适配器把本地 27B 编码模型变得更好。现在又有一个本地 AI 推理引擎提出了一些非同寻常的说法!
TokenWing 是一个 124B 模型,在只有 12GB 显存和 32GB 内存的笔记本电脑上能达到 45–50 tps 的生成速度!这个模型约 70GB 的权重根本装不进机器的内存和显存总和。
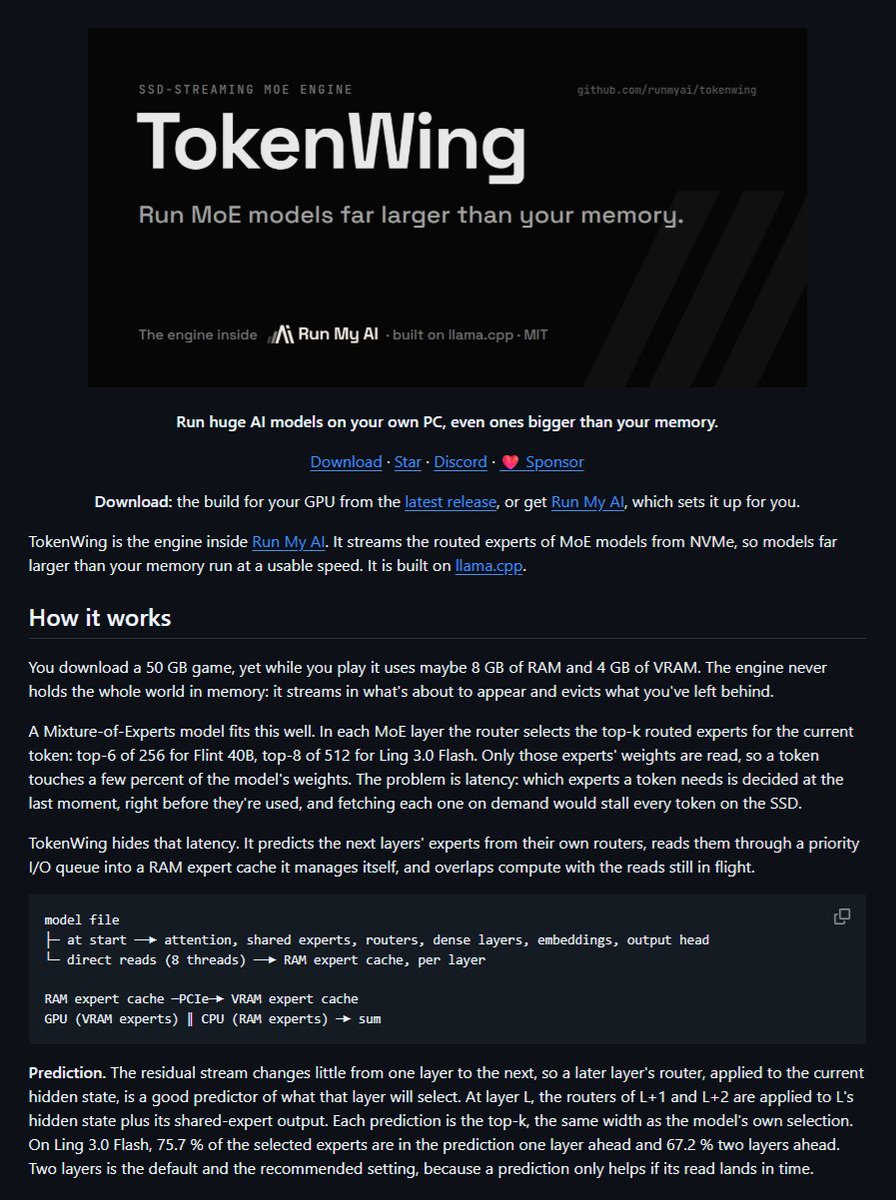
与正在脱离 llama.cpp 矩阵内核的 Strata 不同,TokenWing 是建立在 llama.cpp 之上的。它的诀窍是什么?预测接下来需要哪些 MoE 专家,并在模型运行到这些专家之前,就从 NVMe SSD 把它们流式加载进来。
看看社区初步报告的结果。
模型 → 硬件 → 生成速度
🧠 Ling-3.0 Flash 124B
💾 12GB 显存 + 32GB 内存
🚀 45–50 tps
🧠 Qwen3.8-Flash-Next 180B
💾 8GB 显存 + 32GB 内存
🚀 35–40 tps
🧠 Recursive Flint 40B
💾 4GB 显存 + 24GB 内存
🚀 30 tps
发布方声称这些速度是在没有 MTP 投机解码的情况下实现的。在 MoE 模型中,每个 token 只会激活一小部分专家。但当这些专家存在 SSD 上时,按需获取它们会显著拖慢推理速度。
👉TokenWing 试图通过预测未来的专家选择来解决这个问题。(说实话 Strata 也在做这件事)
在 Ling-3.0 Flash 上,其开发者报告:
🎯 75.7% 的被选专家能提前一层被预测到
🎯 67.2% 能提前两层被预测到
然后 TokenWing 会这样做……
⚡ 从 NVMe 预取预测到的专家
💾 把它们缓存在可用内存中
🎮 把高频使用的专家保留在显存中
🔀 让 SSD 读取与 CPU/GPU 计算重叠进行
目标是隐藏 SSD 延迟,而不是每个专家都要等。
而且它现在就能用……
🔓 开源,MIT 许可证项目
🟢 支持 NVIDIA 和 AMD GPU
💻 支持 Windows 和 Linux
🧠 支持纯 CPU 模式
🔌 兼容 OpenAI 的本地服务器
💾 需要 NVMe SSD
但深入看这些帖子,这些速度只是初步说法,还没有经过独立复现的基准测试。一位早期用户报告说,在 Qwen3.8-Flash-Next 上只跑到不到 20 tps,远低于宣传的结果。自动调优器还没完成,长提示词会在专家缓存调整期间拖慢首批生成的 token。我们还需要在不同 GPU 型号、量化方式、SSD 速度和上下文长度下做正式测试。
🔗TokenWing GitHub 链接在 ALT 中。
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖