
Da7em Bench v2.0 上线,11个AI模型实测对比
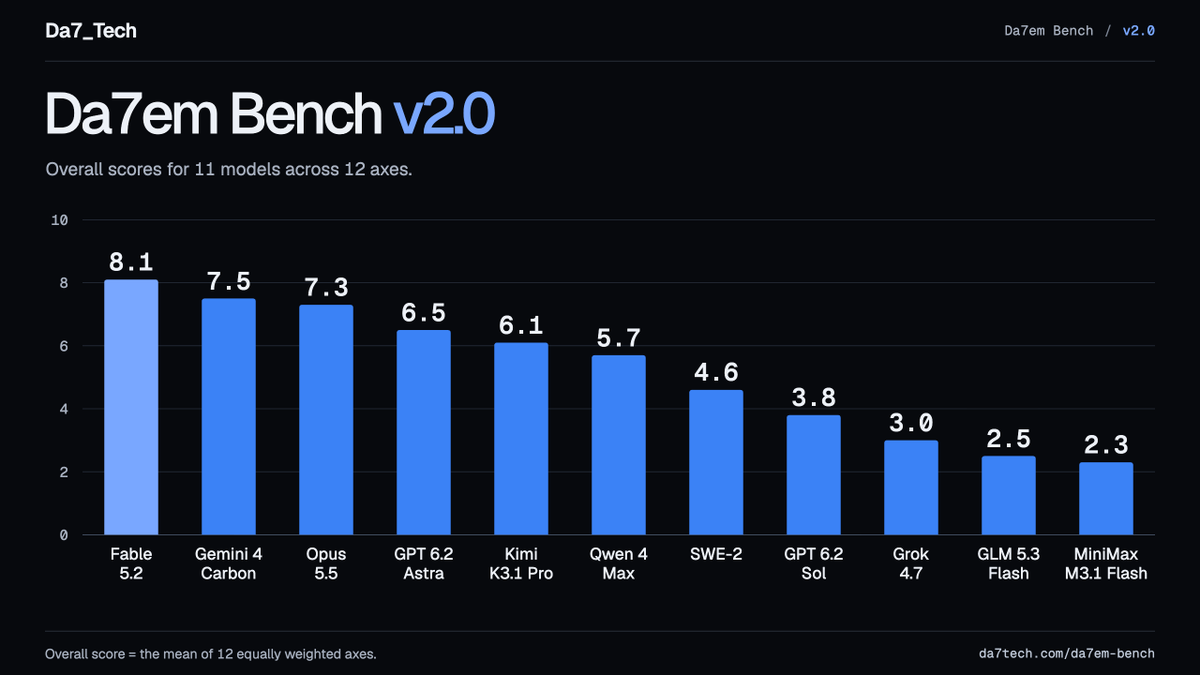
Da7em Bench v2.0 来了。这是一个完全独立的 AI 模型基准测试,基于真实的客户工作构建。在全球范围内尚属首例。
它的运作方式是:我在各种场景下测试每个模型。我将它的决策与人们在相同情况下做出的选择进行比较,并与人们普遍认为最合理的选择进行比较。模型在几个方面仍然落后于人类。得分越高,意味着模型的决策越接近人类的选择。得分越低,意味着它们离人类的选择越远。
和以前一样,我在多个测试环境中公正地测试每个模型。标准是专业工作。我根据付费专业人员在相同简报下会交付的成果来评判每个结果。
第 2 版涵盖了 11 个模型,横跨 12 个维度。每个维度的满分是 10 分,总分是所有 12 个维度的平均分。任务和评估方法保密,以免它们泄露到训练数据中并影响未来的结果。
Da7em Bench 帮助你为每项任务选择模型。视觉品味最好的模型可能不是最好的作家。规划能力最好的模型可能不是执行该计划的最佳模型。
Da7em Bench 是完全独立的。没有赞助商或外部资金。所有费用都是我自掏腰包支付的,到目前为止已经花了数千美元。我想纳入更多的模型。这是一个个人基准测试,靠我自己覆盖所有模型需要时间和精力。
这四张图片分别展示了总体排名、每个模型在每个维度上的得分、分为四大支柱的十二个维度,以及 Claude Fable 5.2 和 GPT 6.2 Astra 的并排比较。你可以在这里探索完整的基准测试并比较任意两个模型。https://da7tech.com/da7em-bench/?lang=en
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖