
Contra Labs发布Frontier Design Benchmark(33个设计任务)
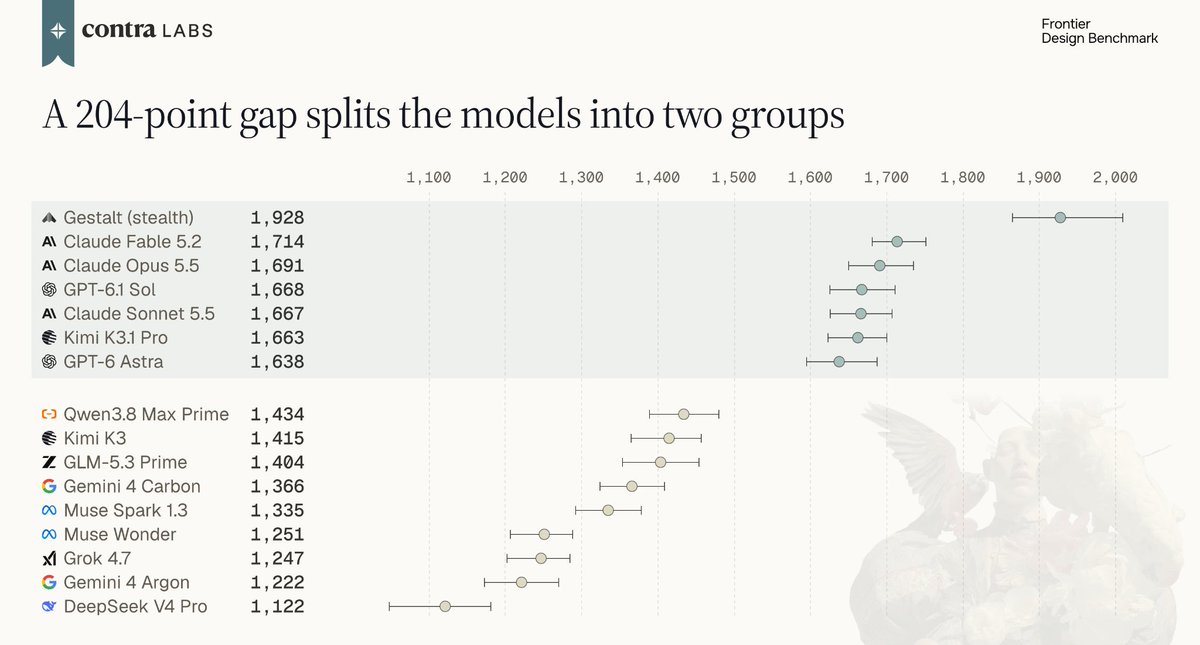
🚨一个还没公开的神秘模型,把Claude、GPT、Kimi全干死了。Contra Labs刚刚发布了一个Frontier Design Benchmark,专门测试AI完成真实商业设计项目的能力。他们从真实客户需求中整理了33个设计任务,邀请专业设计师对不同模型生成的网站和产品界面进行盲评,累计超过4300次投票。
结果第一名是一个叫Gestalt的神秘模型,目前还处于Stealth阶段,开发团队尚未公开。它的Elo达到了1931,胜率90%。相比之下,Claude Fable 5.2只有1713,人类设计师的参考作品是1739。
在直接对比人类设计稿的28次盲评中,Gestalt赢了20次。而且整个榜单还出现了非常明显的能力断层。Claude、GPT和Kimi K3.1 Pro基本处于第一梯队,Elo集中在1638~1714。
其中Kimi K3.1 Pro达到了1663,距离GPT-6.1 Sol只有5分。第二梯队从Qwen3.8 Max的1434开始,中间直接差了204分。但我现在更好奇的是,这个Gestalt到底是谁做的?
如果后续独立测试也能复现这个成绩,那设计领域可能真的出现了一个值得关注的新模型。PS:我看有人说是Ilya的模型??