
Loopback Transformer 新架构,训练算力不变还能少堆参数
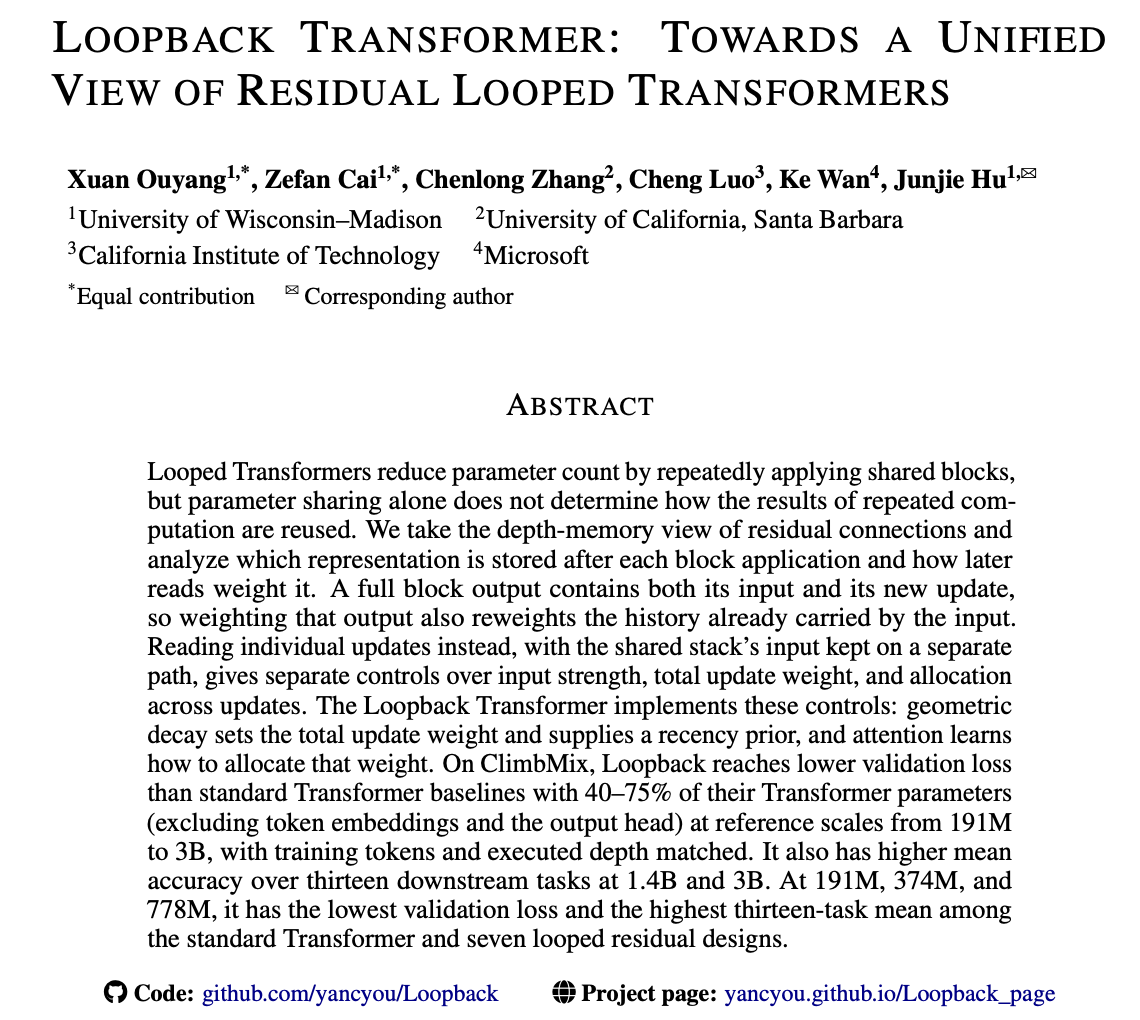
循环模型需要一种新的残差设计吗?分享我们的新工作:Loopback Transformer 🔁
在训练 FLOPs 几乎相同的情况下,模型能否用更少的 Transformer 层参数,仍然优于标准 Transformer?
共享层可以节省参数。但再次运行相同的层会引出另一个问题:哪些信息应该在多次传递中保留,哪些更新应该逐渐淡化?
受循环模型启发,我们提出了一个统一视角,将残差连接视为跨深度的记忆:写入、传输和读取。它将普通残差、Attention Residuals、Hyper-Connections 和线性注意力读取器纳入同一个框架。
Loopback 将这一视角付诸实践:存储每个块的更新,对较早的传递进行几何折扣,并使用注意力检索有用信息——即使来自更早的循环。原始输入保留在自己的路径上。
⚡ 在训练 token 数和执行深度匹配的情况下:
• 1.4B:使用标准 Transformer 68% 的层参数,验证损失更低,13 项任务平均分更高。
• 3B:使用 75% 的层参数,13 项任务中赢下 11 项,平均准确率从 48.56% 提升至 49.45%。
• 在 191M、374M 和 778M 规模下,主要对比结果显示,Loopback 在标准 Transformer 和七种循环残差基线中,验证损失最低,13 项任务平均分最高。
如果你觉得这项工作有用,在 Daily Papers 上点个赞、在 GitHub 上点个 star,能帮助更多人发现它!🤗
Daily Papers 上的论文:⭐ 代码:
下面是核心思路、视频和结果 🧵 1/11
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖