
Sebastian Raschka拆解位置嵌入:从GPT-2到2026开源模型
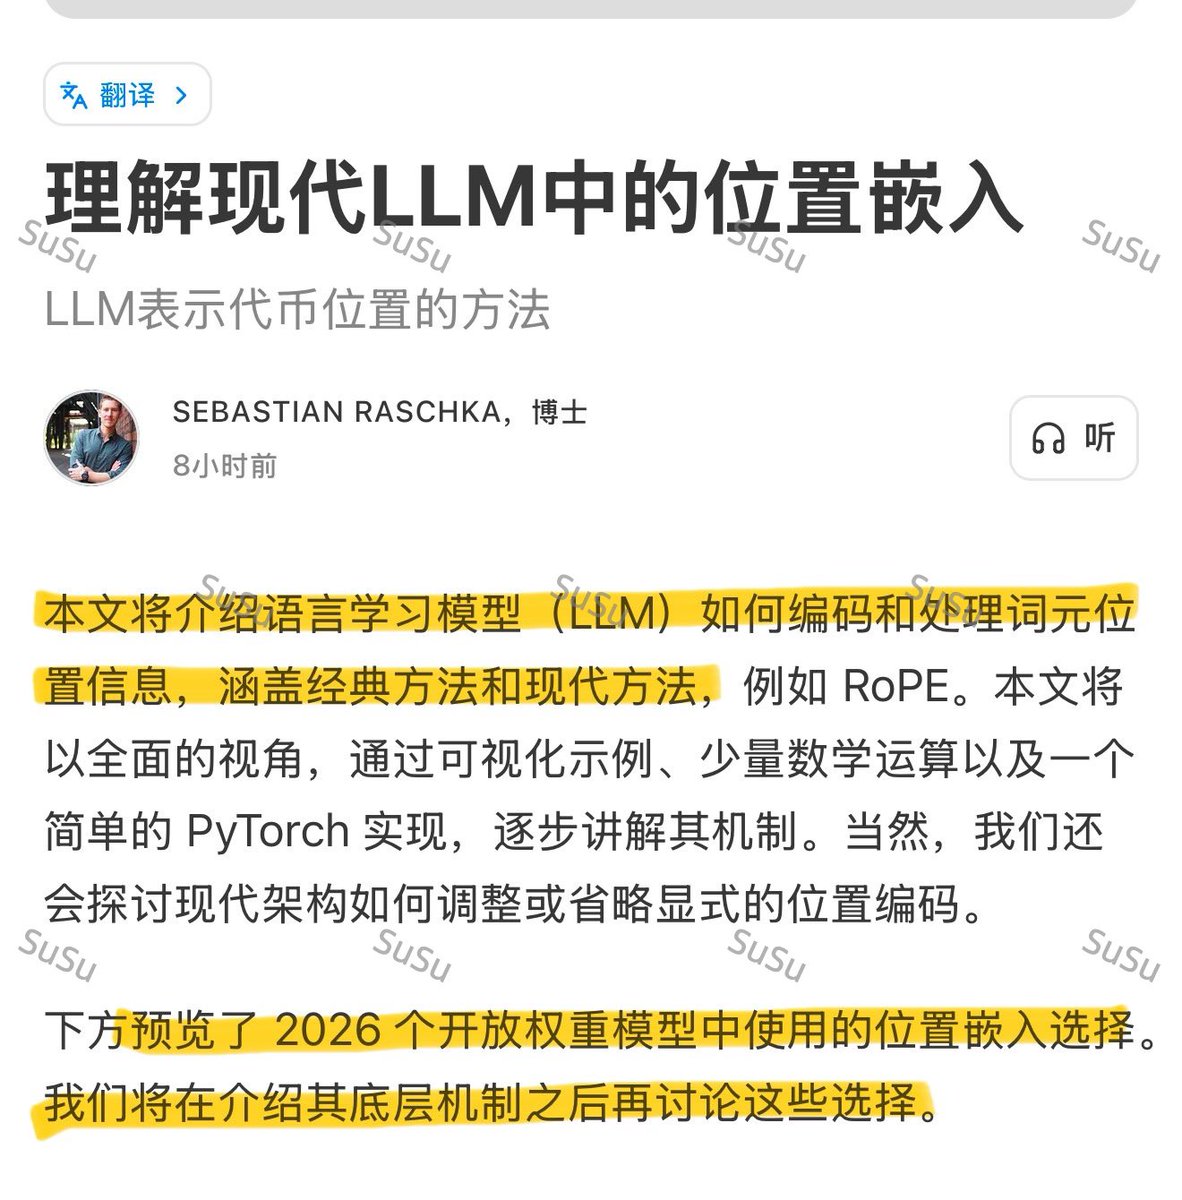
🔥DeepSeek、Qwen等开源模型怎么“知道”词的顺序?! Sebastian Raschka刚发硬核长文,把位置嵌入从GPT-2到2026开源模型彻底拆透了
关键发现:
🔹没位置信息,Attention分不清“狗咬人”和“人咬狗”
🔹GPT-2用绝对位置向量,一拉长上下文就爆炸
🔹RoPE(旋转位置编码)成主流:在Attention里旋转Q和K,相对距离直接进点积。DeepSeek、Qwen、Llama全在用,超长上下文神器
🔹惊喜NoPE:完全不加显式位置,只靠因果掩码就能隐式学到顺序,长度泛化有时更好
🔹2026趋势:MiniMax-M3用Partial RoPE(只旋转一半维度省内存),SmolLM3则是3层RoPE+1层NoPE混合,越来越多模型在玩“选择性加位置”
开源模型(DeepSeek、Qwen、Llama、MiniMax、SmolLM3)全透明可复现,闭源(GPT、Claude、Gemini)细节不公开,但大概率也是RoPE变体或更激进的混合方案。
想真正懂现代LLM架构,这篇文章必看。
#LLM #AI #RoPE #位置编码 #大模型 #开源AI #DeepSeek #Qwen #Llama #MiniMax #nope