
Meta FAIR + NYU发布论文《Unbundling Multimodal Vision Encoding》
😲什么?!多模态视觉能力的关键竟然不是预训练编码器?!谢赛宁新作炸场!
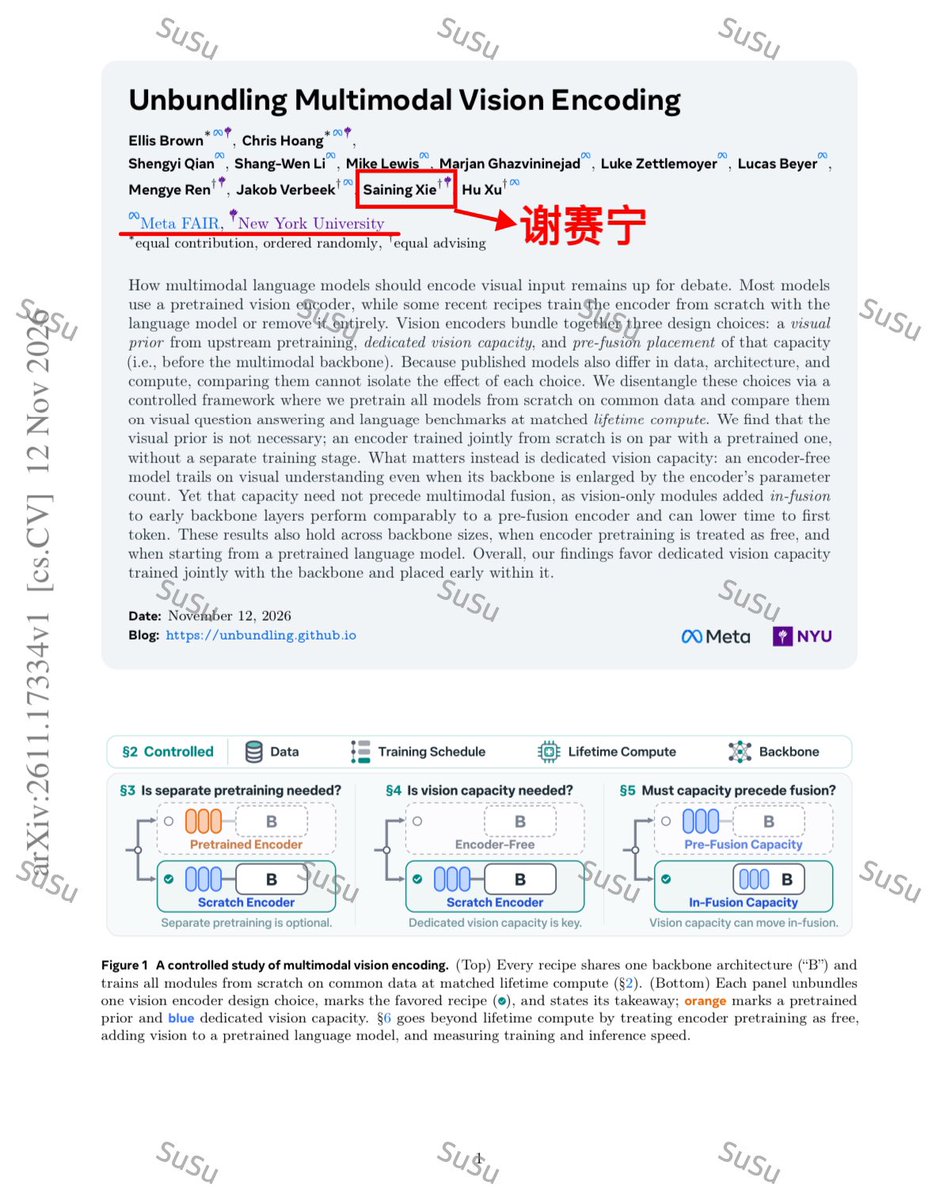
Meta FAIR + NYU 刚发的论文《Unbundling Multimodal Vision Encoding》,把视觉编码器拆成三件独立选择,用同一数据、同一架构、全生命周期算力严格对照,结论直接颠覆常识。
核心发现分三点:
1️⃣预训练可以彻底省掉
视觉先验(CLIP那一套单独预训练)根本不是必须的。从零开始和语言模型联合训练的编码器,效果完全追平甚至持平预训练版。多训图像识别准确率上去了,但VQA几乎不动。
2️⃣视觉专用参数绝对不能省
真正拉开差距的是“有没有一块专门给视觉的参数”。无编码器方案就算把参数全加到主干上(加宽、加深都试了),视觉理解依然明显落后,要追上差不多需要约3倍算力。从0.6B到6.4B结论都稳。
3️⃣位置可以挪,挪进主干早期还更快
专用视觉参数不必放在融合之前当独立编码器,直接塞进主干最前面几层(in-fusion)效果相当,而且首token延迟更低,因为去掉了“编码器必须先跑完才能进主干”的串行瓶颈。
总结:视觉能力的关键不是“先预训练”,而是有没有专门留给视觉的参数,以及它放得够不够早。
少一个训练阶段、推理更丝滑、训练更简单,对做多模态的人直接改变设计思路。
论文:
项目页:
#AI #Multimodal #VisionEncoder #SainingXie #MetaAI #大模型 #Meta #纽约大学