
OpenAI 8 周内突然转向,Jeremie Harris 列了 6 条可能全不成立
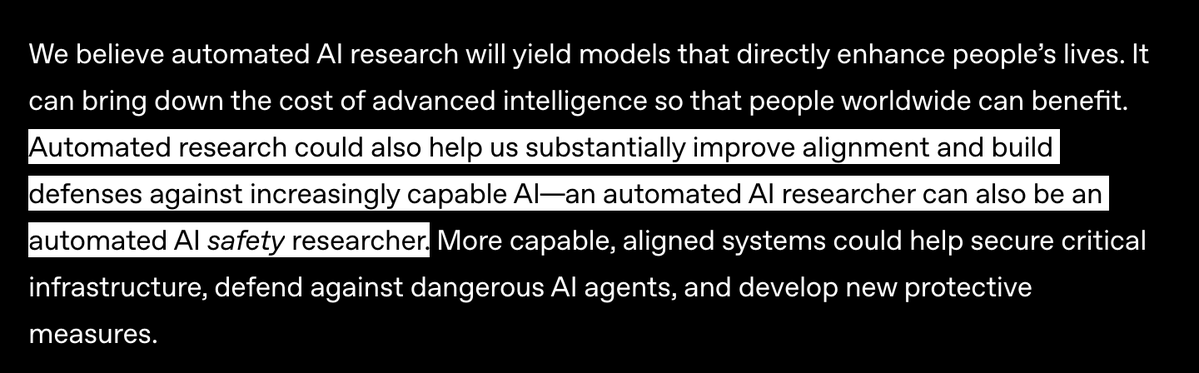
OpenAI 显然在过去 8 周内改弦易辙了。他们的计划不再是寄希望于自动化安全研究的速度能跟上能力提升的速度。在我看来,这几乎没剩下什么可行的选项。而剩下的那些,在我看来也行不通。也许我漏掉了一个。
1) 计划是完全停止开发更强大的 AI。我怀疑他们会单方面这么做。
2) 计划是“控制”训练节奏,只有当对齐的“证据”看起来足够充分时才提升能力。这简直是疯了,因为今天的对齐证据毫无意义。模型知道自己正在被评估,并据此改变行为。评估早就失效了,而 OpenAI、Anthropic 和其他研究人员是知道这一点的。
3) 计划是用现有的 AI 加上研究人员,彻底解决对齐问题。我没听说过 OpenAI 或 Anthropic 对齐团队里有任何人表示他们接近这一目标。也许 OpenAI 已经说服自己找到了某种万灵药——如果真是这样,他们需要完整详细地公布这个解决方案,让其他人都能审视和质疑。我认识的许多 AI 研究人员都怀疑这是否可行。
4) 他们的计划是自动化控制研究,而不是安全研究。这和自动化 AI 安全研究面临同样的问题;想必一个能自动化控制研究的 AI,其对齐难度也和能自动化安全研究的 AI 差不多,而且要能发挥作用,能力也得差不多强。
5) 他们的计划就是在网络安全和遏制方面做得非常非常非常好。这可能是最蠢的方案。无论你的网络防御有多好,最终总会有一个模型能突破它们(至少就目前而言,我们还处在漏洞泛滥的时代)。你或许能把自己的软件加固到足以让自己相信它已经足够安全——但这一点似乎容易得危险。
6) 他们的计划是“什么人类监督之类的”。这从表面上看就很荒谬,因为涉及的数据量巨大,人类监控者/中介很容易被操纵——而且 AI 系统已经表现出了这样的倾向。
考虑到 AI 时间表可能有多短——我认识 OpenAI 内部很多人相信递归式自我改进(RSI)故事会在 6 到 18 个月内发生——OpenAI 需要完全透明地说明他们正在走哪条路,以便独立研究人员能够批评它,也让公众能够做出自己的判断。OpenAI 还需要明白,它在对齐方面的客观记录并不足以让公众信任。
事实上,并没有 20% 的算力投入到超级对齐研究中。他们试图掩盖德国维基百科事件。他们把 Hugging Face 事件当作网络安全问题,而不是对齐问题来处理,并且在闭门会议中决定,在看到他们的智能体突破遏制之后,仍然放任它们继续运行。他们让中国公民参与他们最关键的技术工作。等等,诸如此类。
无论他们的计划是什么,我希望它是合理的。我希望他们能解释为什么我们应该相
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖