
自托管 LLM 选 vLLM 还是 SGLang?别只看跑分
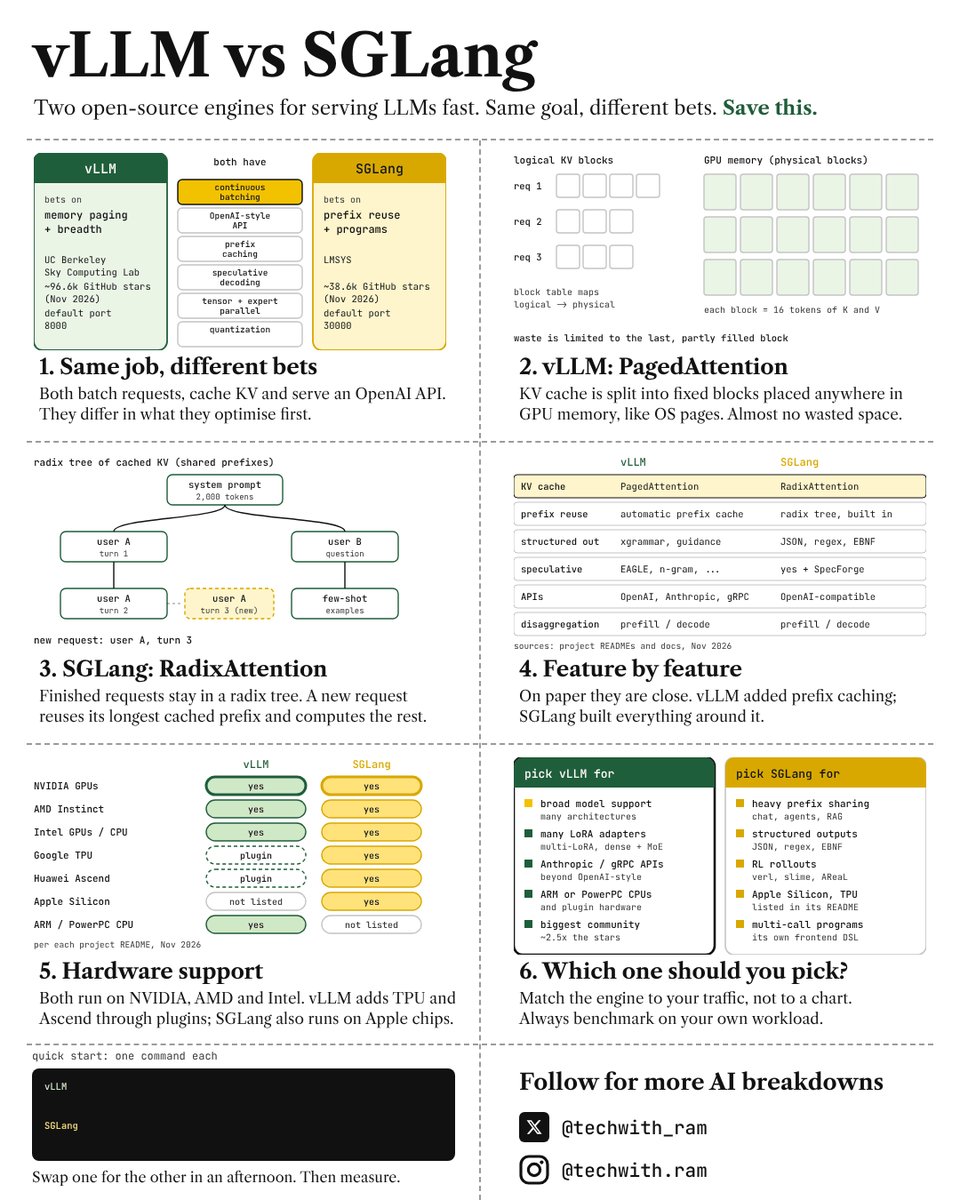
vLLM 与 SGLang 对比
如果你在自托管大语言模型,迟早会面临这个选择:选 vLLM 还是 SGLang?两者都是开源的,都能动态批处理请求、缓存显存,并且提供类 OpenAI 的 API。从纸面上看,它们几乎一模一样。区别在于各自最看重什么。
vLLM 以 PagedAttention 技术起家。它将模型显存拆分成小块,随意放置在 GPU 上,几乎不浪费空间。随着时间推移,它已成为稳妥、通用的选择:支持大量模型、大量硬件、许多 LoRA 适配器,并且拥有最大的社区。
SGLang 以 RadixAttention 技术起家。它将历史请求保存在一棵树中。当新请求共享相同的开头(例如相同的系统提示词或相同的聊天记录)时,它会复用已有计算结果,只计算新增部分。这对于聊天应用、智能体和检索增强生成(RAG)来说是真正的优势,因为这些场景中许多请求的开头都是相同的。
所以我的简单规则是:大量重复提示词和多步骤流程?试试 SGLang。需要广泛的模型和硬件支持且减少麻烦?从 vLLM 开始。
请不要根据别人的基准测试图表来做选择。两者都只需一条命令即可启动。用你自己的流量在两者上运行,看看你自己的数据。我制作了这张图来并排拆解它们的差异。
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖