
LlamaIndex 把文档 OCR 拆成两条赛道
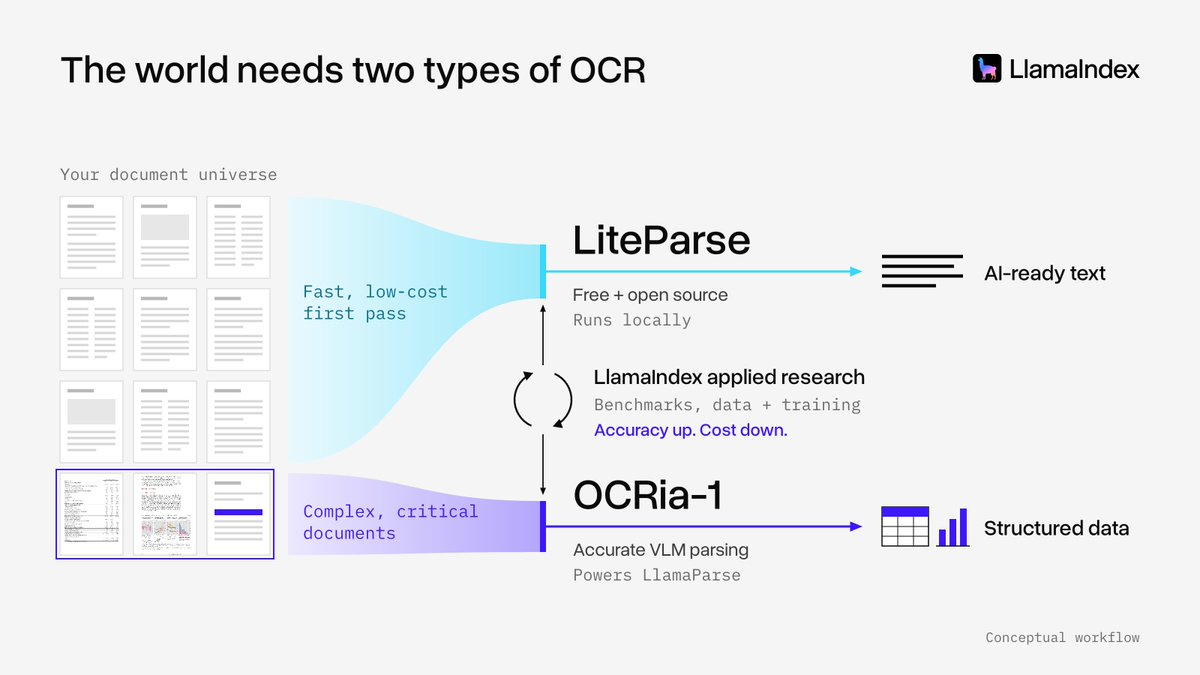
世界需要两类文档 OCR:
1. 极快/极便宜的 OCR 工具:每个组织可能拥有数万亿份文档,这类工具通常作为“第一遍”数字化每份文档,以便 AI 智能体可以访问。准确率可能不是最高的,但对于智能体检索和更深入的第二遍处理来说已经“足够好”。这包括 pypdf、pymupdf 等免费/开源工具。过去一年,我们通过 `liteparse` 在这一领域投入了大量精力——这是最快/最准确的免费/开源解析器。它与另外 5 个开源权重 OCR 工具集成,最近与 @OpenBMB 的 MiniCPM-OCR 集成。我们在这一领域还在做更多工作——敬请期待!
2. 基于 VLM 的高精度 OCR:这包括文档中 a) 复杂且 b) 组织必须准确解析的子集。数据需要准确,因为这些数据被用于金融、保险、医疗保健等领域的关键业务流程。同时,即使工具不是免费的,任何 VLM 都需要能够以具有成本效益的方式扩展到数十亿页。两周前,我们推出了 OCRia-1,这是用于文档解析的最佳通用模型。它不仅能解析复杂的文本布局、复杂的表格,还能解析视觉图表和图形。它为我们在 LlamaParse 中的所有模式提供支持;请查看 ParseBench 上的最新基准测试:
-------
这两类文档 OCR 都需要严格的基准测试、数据+训练流程,以及一支雄心勃勃、人才密集的团队来推动准确率和成本的帕累托前沿。如果你想在任一前沿解决文档理解问题,来和我们聊聊!
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖