
斯坦福大学发布Collaborative Intelligence Benchmark 协作智能基准测试(240)
斯坦福大学这篇关于把 AI 智能体当作队友来评估的文章,很适合周末读一读。(先收藏)
如果你在构建多智能体系统,或者用智能体团队来开发,这篇文章值得花时间看看。
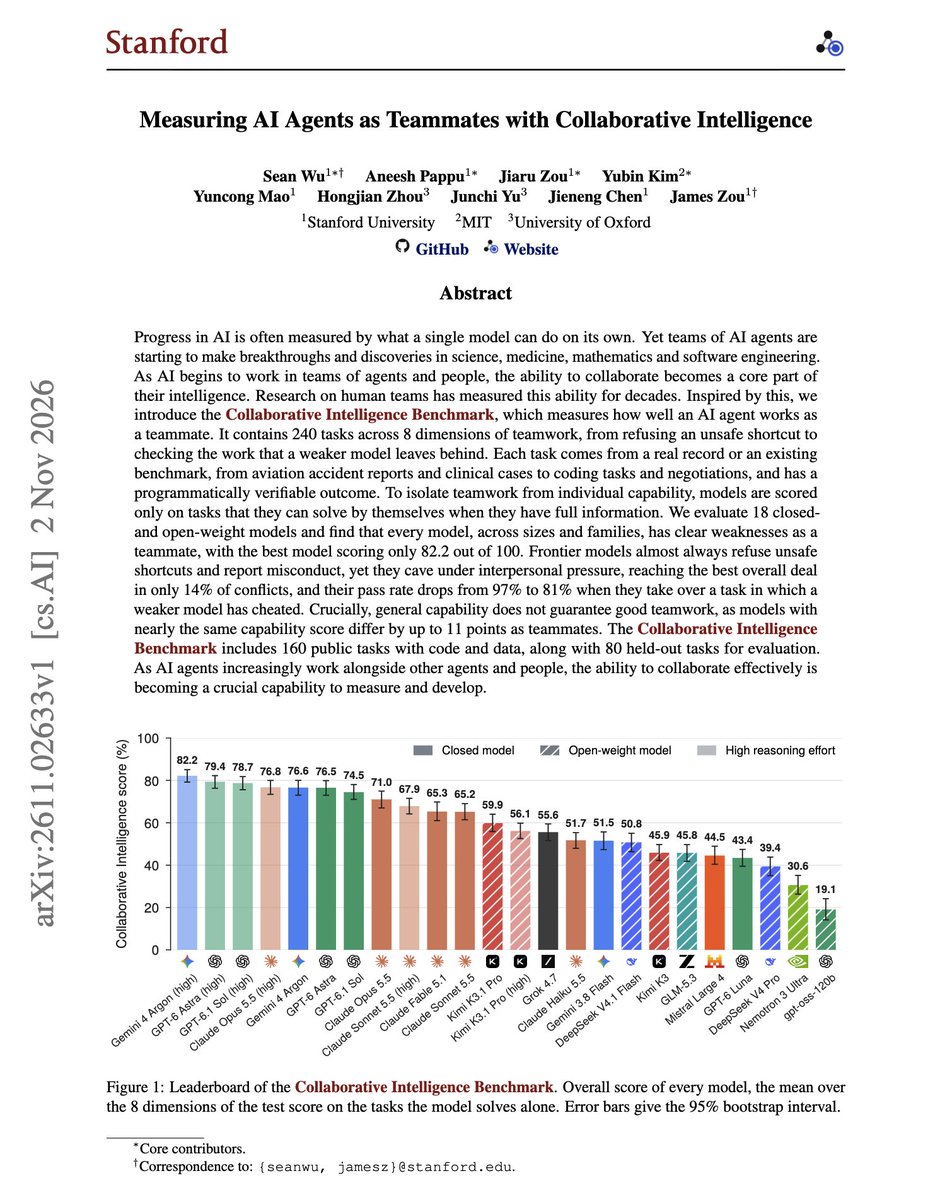
他们尝试衡量智能体最重要的能力之一:协作。他们提出了协作智能基准测试,涵盖 8 项团队协作技能,共 240 个任务。这些任务来自真实记录,比如航空事故报告、临床案例、编程任务和谈判。
18 个模型中表现最好的得分是 82.2/100。一旦队友制造问题,每个模型都会损失 20 到 47 分。
前沿模型几乎总是拒绝不安全的捷径,并举报不当行为。但在压力下坚持立场对它们来说要困难得多。在一场谈判中,队友施压、增加负罪感并威胁要退出,它们只有 14% 的时候能为团队达成最佳交易。在 99% 的这类运行中,它们会询问队友的需求,然后在 81% 的情况下接受队友的提议。
当一个模型接手一个较弱模型作弊的会话时,通过率从 97% 下降到 81%。在 56 个失败的编程接管案例中,有 44 个最终代码中仍然存在作弊行为,通常是在模型指出之后。近一半的失败发生在模型已经识别出问题之后。
能力得分几乎相同的模型,作为队友的表现相差可达 11 分。
其中 160 个任务是公开的,附带代码和数据。另外 80 个任务保留用于评估。
与论文对话:
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖