
TPN_Labs开源大模型轻量化技术
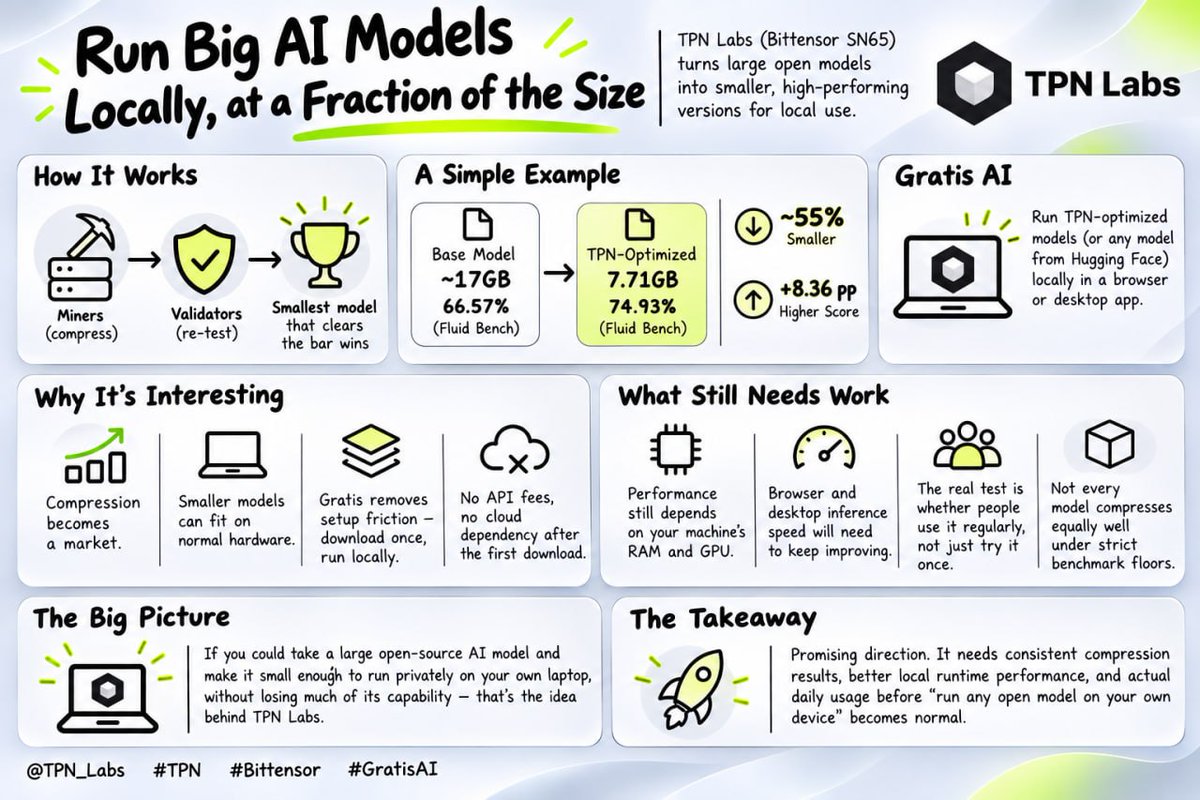
如果能把一个大型开源 AI 模型压缩到足够小,让它在你自己的笔记本电脑上私密运行,同时又不损失太多能力,会怎么样?这就是 @TPN_Labs(Bittensor SN65)背后的理念。
矿工们在真实硬件上限和基准下限的约束下,竞争压缩模型。验证者会重新运行测试。在达标的前提下,体积最小的模型获胜。
@Gratis_AI 随后会采用这些模型(或来自 @HuggingFace 的任何模型),并在浏览器或桌面应用中本地运行。
最近一场比赛的简单示例:
▸ 基础模型:约 17GB,在 Fluid Bench 上得分 66.57%。
▸ TPN 优化版本:7.71GB,在同一基准上得分 74.93%。
▸ 体积缩减约 55%,而分数反而提高。
为什么这很有意思:
▸ 压缩从单纯的研究问题变成了一个市场。
▸ 更小的模型确实能在普通硬件上运行。
▸ Gratis 消除了安装摩擦:下载一次,本地运行,每次提示都留在你的设备上。
▸ 没有 API 费用,首次下载后也不依赖云服务。
但仍有需要改进的地方:
▸ 性能仍然在很大程度上取决于你机器的 RAM 和 GPU。
▸ 浏览器和桌面端的推理速度需要持续提升。
▸ 真正的考验在于人们是否经常使用它,而不只是试用一次。
▸ 并非每个模型在严格的基准下限下都能获得同等良好的压缩效果。
方向很有前景。在“在自己的设备上运行任何开源模型”变得普遍之前,它需要稳定的压缩结果、更好的本地运行时性能,以及真实的日常使用。
$TAO #TPN #SN65
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖