
开发者将DGX Spark塞进衣柜运行,Qwen 3.8 Flash Next达70 tok/s
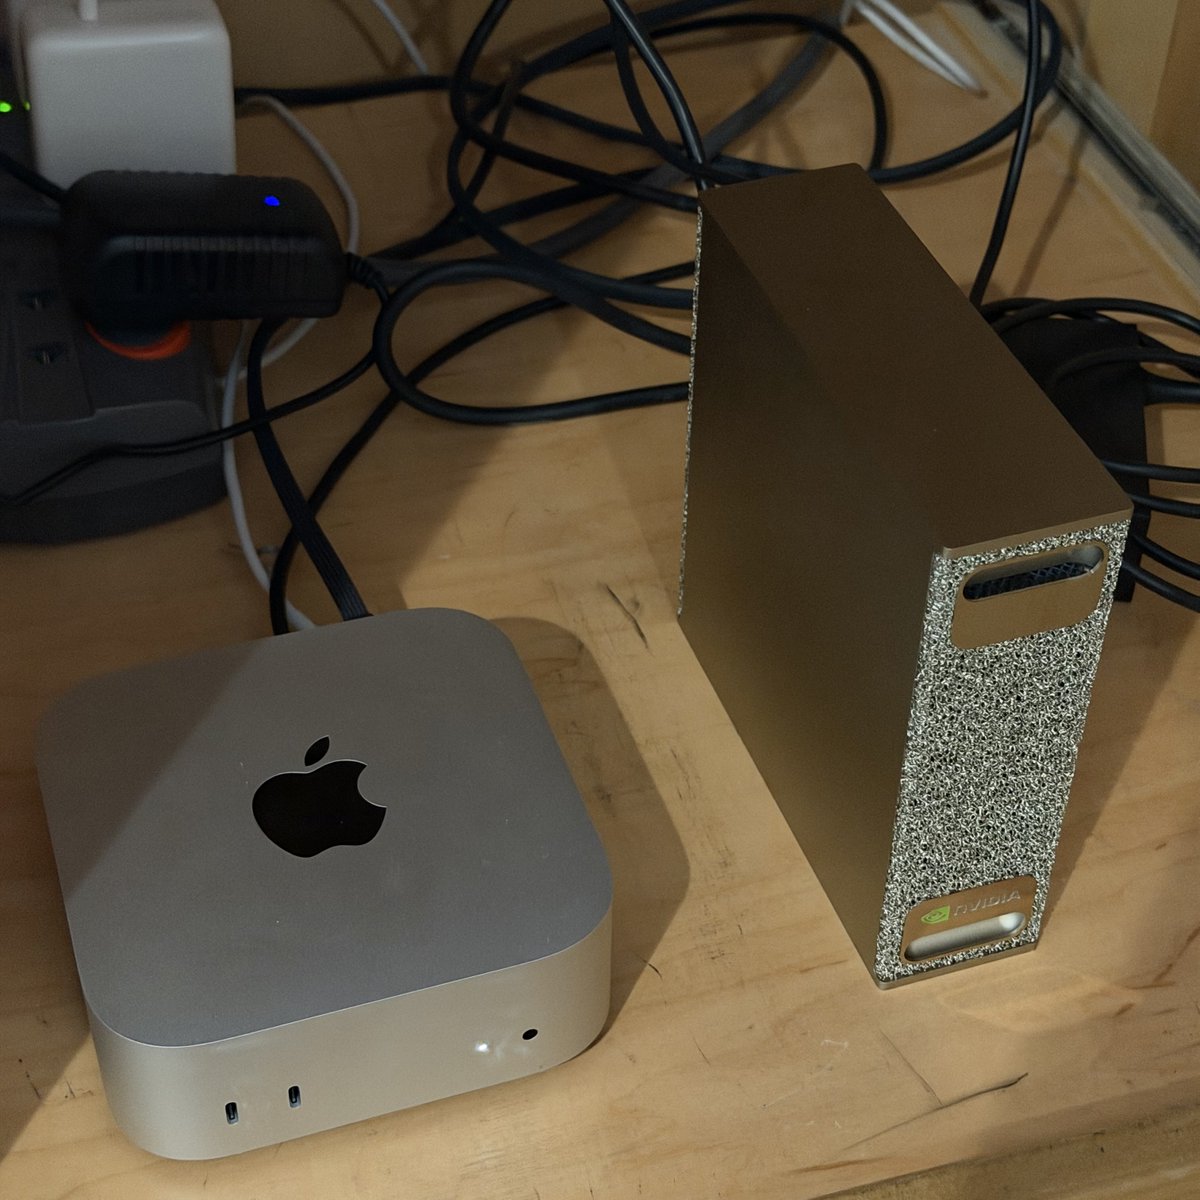
开发者twid在X平台分享了自己的DGX Spark部署方案,这台设备被放在衣柜里运行,是为客户搭建的原型机,后续客户将采用双Spark配置。
当前运行的配置包括:Qwen 3.8 Flash Next(采用MiaAI_lab提供的部署方案)、支持两个并发请求、Laya系统1决策模型、Hermes Agent作为执行框架。目前运行效果良好,内存占用符合预期,Qwen模型的推理速度约为70 tok/s,开发者表示可能还需要再添置一台设备。
Qwen 3.8采用FP4量化版本,模型为nvidia/Qwen3.8-Flash-Next-FP4-Local,通过tensorfold-native 1.1.4提供服务,启用FP8 KV缓存,支持262K上下文、MTP投机解码(46K草稿,接受率稳定),同时开启思考模式与视觉功能。
内存方面,GB10统一内存池总容量为121 GiB。运行Qwen的tensorfold-native进程占用约92.5 GB(服务器报告活跃占用96.7 GB,峰值99.6 GB);运行Laya的laya-serve进程(3个检查点在CUDA上)占用约4.8 GB。Laya仅在工作流需要做出判断时被调用。
开发者表示当前推理速度不错,但该设备的能力还不及Opus模型,目前正使用Opus编写设备将要运行的代码、流程与界面。Deepseek v4.1 flash作为执行框架与工具调用模型表现出色,后续将在双Spark配置的生产环境中执行Opus生成的内容。开发者表示自己还不熟悉Qwen flash next,目前只有一台Spark,正在试用该模型。