
跑了 1129 次实验,LLM 架构的红利已经吃完了
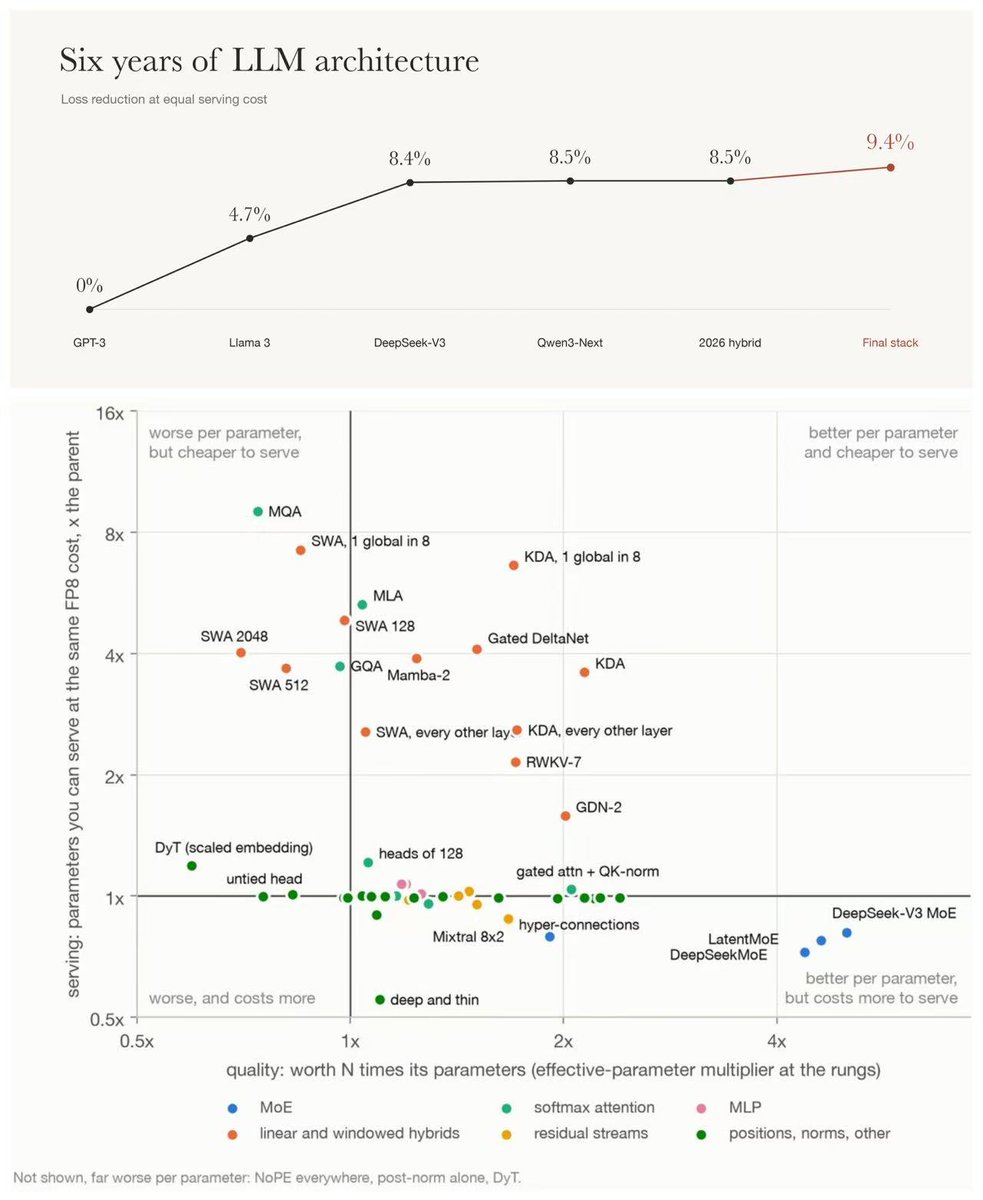
LLM 模型架构的红利,已经被吃完了
读了一篇关于模型架构的文章,2020 年以来那么多 LLM 架构改动,放到同一套实验设置里,到底哪些是真的有用?
作者 Nikita Pavlichenko(前 JetBrains Mellum 预训练负责人)跑了 1129 次训练实验。他训练的是小模型,上下文和质量评测只到 16k;目标大模型的 loss 则靠 scaling law 外推。
1/ 问题不应该问“架构好不好”,真正值得关心的是,在相同推理成本下,最终能得到多好的模型。
他给每个架构相同的推理预算,服务便宜的架构就能换更大的模型。换了这把尺子,很多结论是反的:GQA、MQA、滑动窗口的每参数质量其实更差,但缩减 KV cache之后能上 4-9 倍大的模型,所以反而赢。反过来,纯比每参数智能,完整 MHA 胜过 GQA、MQA 和滑动窗口,MLA 与它持平。
推而广之,架构论文如果只报 loss per parameter,结论都得打个问号,因为它没算部署那一头的账。
2/ 过去六年,最扎实的进步是:细粒度 MoE 和线性注意力。
MoE 让一个激活参数顶 dense 模型的 4-5 个,是最容易拿到的胜利,而且随规模变好。线性注意力混合架构(KDA、Gated DeltaNet、Mamba-2)既提升质量又便宜 2-7 倍。但线性注意力的优势大部分来自它和 SWA 共有的东西,在完整的 2026 模型里只比滑动窗口好 0.3%。他猜这可能是西方开源实验室不急着上线性注意力的部分原因。
3/ 架构红利基本被 DeepSeek-V3 那一代吃完了,后面的空间明显变小了。
他把 loss 拆开看:2026 模型的预测 loss 里,只有约 2% 是参数不够造成的,架构能改进的就是这一项。2021 年的 GPT-3,这个空间是 11%。换句话说,DeepSeek-V3 那一代就已经把这块拿走了大半。
这也能解释为什么现在各家架构越来越像,为什么“前沿实验室在训最无聊的 Transformer”这种传言听起来可信。不是大家懒,是剩下的空间真的不大。
4/ 小模型上的消融结论不能直接信,缩水系数大概是 1.5 到 3 倍,有些直接翻号。
这条对所有看 nanoGPT speedrun、看 modded-nanogpt 新纪录的人都适用。他给的经验法则很实用:d=512 上帮助不到 1% 的改动,不看第二个宽度别加。embedding 乘 √d 从帮 0.73% 翻成伤 0.79%,就是活例子。
5/ 数据和训练方法,可能比继续抠架构更值得投入。
他发现,仅仅把优化器换成 Muon,收益就能抵上一整轮架构改动叠加。一般架构配好的训练方案,完全可能打赢顶级架构配普通训练方案。而且 Muon 的收益随规模增加,比多数小架构改动保持得更好。数据这块他没测,只说预计有类似量级的收益。
6/ 推理 kernel 决定架构成败的程度被低估了。
Gated DeltaNet-2 在最小的 d=512 上每参数最好,实测 -4.7%,但 vLLM 跑它只有 KDA 的 0.42 倍速度,算到等服务成本下只剩 -2.9%。MLA 这次也没进最终模型,一半是模型太小,一半是 vLLM 对小 MLA 形状跑不快;他说目标模型再大一点,MLA 很可能就进去了。架构研究和推理工程已经分不开了。
另外,他对 AI 做研究的评价:实现和调试已经很强,研究判断还不够可靠。
AI 能半小时写出他要一天才能实现的架构,却可能漏掉最明显、最值得尝试的组合。不过他觉得这块很快也会补上,就像 coding 一样。