
Qwen3.8-27B 被魔改成全线性注意力,24G 内存就能跑
💥逆天!史诗级魔改!仅需24G内存跑通!Qwen3.8-27B全64层变纯线性注意力,262K长文秒杀级神器来了!
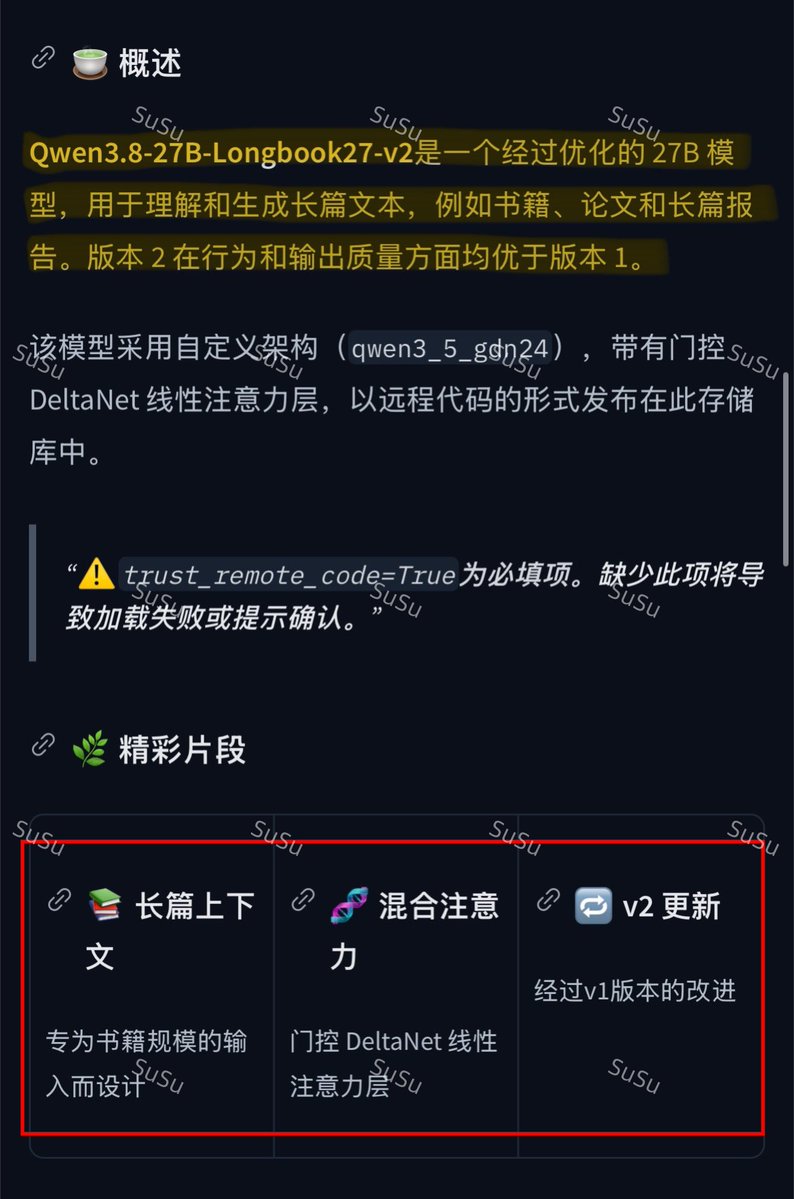
原版是48层Gated DeltaNet + 16层全注意力的混合架构。这个自定义版本直接把那16层全注意力也转成Gated DeltaNet,做成100%纯GDN模型!
核心亮点:
🔹全层线性注意力:彻底干掉KV Cache爆炸,显存几乎不随上下文增长(相关版本262K仅~55GB且不OOM)
🔹逐层蒸馏+LoRA(r32)恢复精度,不是粗暴替换
🔹专为书籍/论文/超长报告设计,英日双语,262K位置嵌入配置好
🔹4bit约17GB(24GB卡可上),bf16约54GB
🔹自定义架构qwen3_5_gdn24,需trust_remote_code=True
快速上手:
1️⃣pip install -U transformers accelerate bitsandbytes
2️⃣加载(4bit):
model = AutoModelForCausalLM.from_pretrained( "summerAIO/Qwen3.8-27B-Longbook27-v2", quantization_config=BitsAndBytesConfig(load_in_4bit=True, bnb_4bit_quant_type="nf4", bnb_4bit_compute_dtype=torch.bfloat16), device_map={"": 0}, trust_remote_code=True)
3️⃣用ChatML模板,长文总结推荐greedy + repetition_penalty=1.05
直达:
#Qwen3 #GatedDeltaNet #本地LLM #长上下文 #线性注意力 #LocalLLM #开源模型 #阿里巴巴 #刘大一恒