
jayleaton发布Compute Lanes 功能(40)
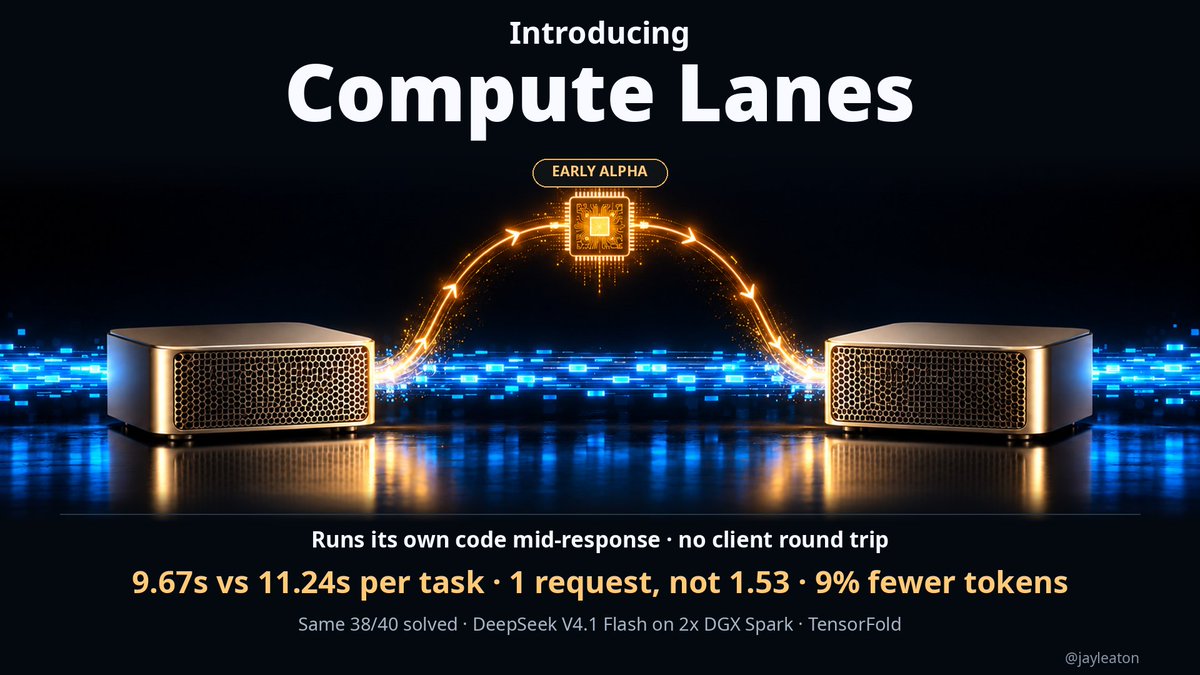
我的 DeepSeek v4.1 Flash 方案现在能在响应过程中运行自己的代码了 ⚡ 介绍一下 Compute Lanes。(早期 alpha 版本。)
引擎还是同一个,但开启后,模型可以在生成响应的同时,把计算任务派发到 DGX Spark 的 CPU 核心上,结果直接回灌到同一次生成里。没有客户端往返。本质上就是模型自己触发的一次内部工具调用,这样它就不用先结束、再等待、然后重新来一遍。
在 40 项编码测试中,同样是 38/40 解出:
- 每个解出任务 9.67 秒,对比 11.24 秒
- 1 次请求,对比平均 1.53 次
- token 少 9%
也就是全部 40 项测试整体快了 16%。
这个想法是在看到 @divagr1925 在权重里实现的东西之后冒出来的。如果我们能在模型还没生成完响应之前就把计算跑掉呢?
哦对了,把 lanes 关掉之后,模型本身也更快了,这要归功于 @bertholomusai 的 KV mirror:
- 代码 107.2 tok/s(+5.1%)
- 散文 48.6 tok/s(+3-4%)
它在这个方案里默认开启,但还没 100% 稳定。稳定之后会有更多更新。
想测试、想了解它怎么工作的话,PR 在评论区。
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖