
开发者24小时烧30亿token仅花87美元,呼吁跳出Claude、ChatGPT依赖
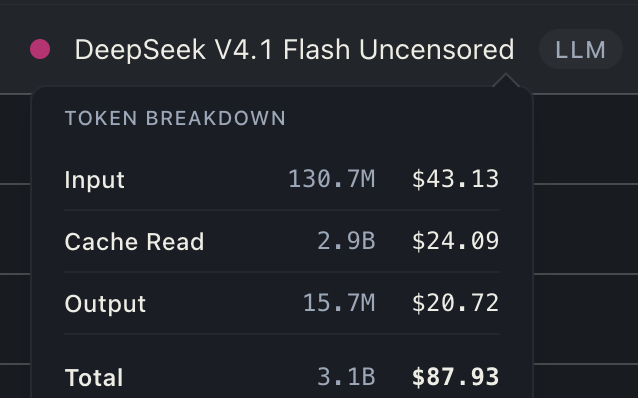
过去 24 小时里,我在无审查版 DeepSeek V4.1 Flash 上烧掉了 30 亿个 token,只花了 87 美元。
如果你现在还不管什么任务都默认用 Claude 和 ChatGPT,那你要完了。
求你了,抽一个周末钻进中国开源权重模型的兔子洞里看看。DeepSeek、Qwen、Kimi、GLM、无审查微调版、去对齐模型、本地推理,全都去摸一遍。
其中有些东西的性价比真的离谱,而 99% 的人根本不知道它们的存在。
你可以用 Ollama、LM Studio 或 MLX 在本地跑小模型。大模型就通过 Venice AI 或其他推理服务商来跑。把它们接进 OpenCode,你立刻就有了一个带终端访问、浏览器工具、文件系统访问的编程智能体,想配什么就配什么。
你根本没必要被绑定在某一个模型或某一家服务商上。
给你一段提示词。直接把它粘进你的编程智能体里:
“调研当前中国开源权重模型生态。包括 DeepSeek、Qwen、Kimi、GLM,以及无审查版和去对齐变体。检查我的硬件,搞清楚我能用 Ollama、MLX 或 llama.cpp 在本地跑哪些模型。对于太大跑不了的模型,对比包括 Venice AI 在内的托管服务商。对比实际输出 token/秒、首 token 延迟、上下文长度上限、输入/输出定价、缓存定价、编程能力和工具调用可靠性。根据我的实际工作负载找出最佳选项,而不是看基准测试排行榜。用符合我预算的最佳本地和托管模型配置 OpenCode。配置好服务商,测试工具调用,优化上下文使用,并在不同端点上对相同任务做基准测试。给我展示你能真正跑通的最快、最便宜、最可靠的配置。在更改我现有配置之前,先把所有东西都验证一遍。”
另外,拜托你搞清楚,模型和推理服务商是两回事。同样的权重,不同的服务商来跑,速度可能天差地别。去看真实的解码速度,而不是广告里吹的吞吐量。
前缀缓存、上下文压缩、量化、模型路由。去研究这些东西。你的智能体可能在反复重读旧的工具输出上花的钱,比真正解决问题花的还多。
还有,别再用昂贵的推理模型去处理那些一个小本地模型或者 20 行 Python 就能搞定的任务了。
太多人连在聊天窗口之外跑一次模型都没试过,就在 AI 订阅上白白浪费了这么多钱,这真的太离谱了。
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖