
Artificial Analysis 发布 Intelligence Index v5,60% 评测改用私有数据集
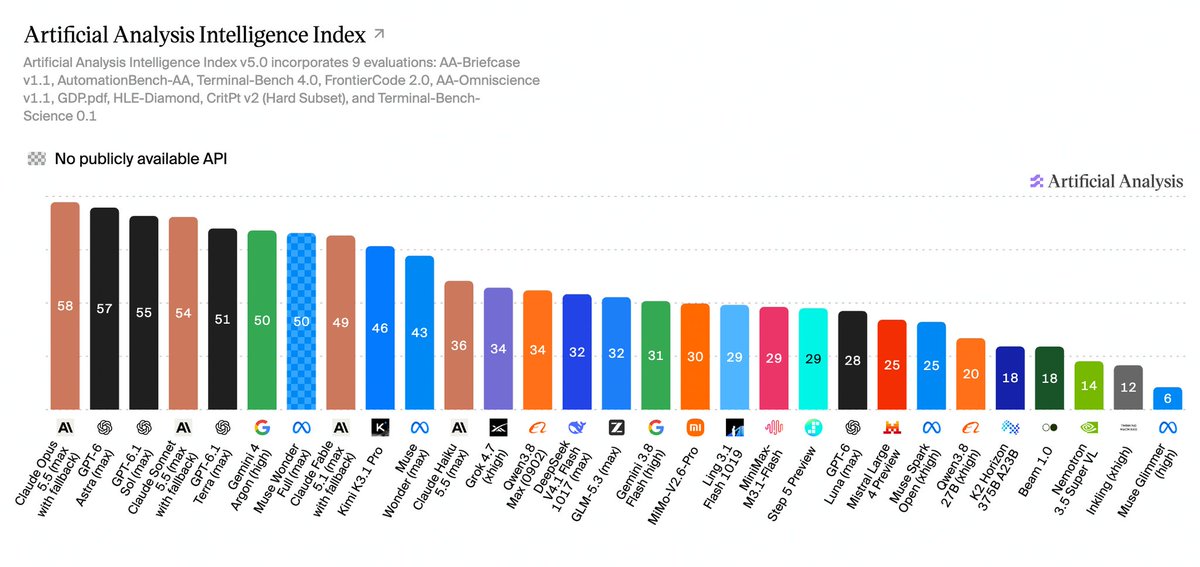
我们发布 Artificial Analysis 智能指数 v5,新增 2 个基准、升级 3 项。指数首次以私有数据集为主体。
Artificial Analysis 智能指数是我们的综合指标,衡量模型在反映当今真实使用场景的各类任务上的能力。v5 是自 1 月 v4 发布以来最大的一次升级。v5 版本中,指数的 60% 现在基于私有测试集或留出答案的评估。
与智能指数 v5 一同发布的还有 Artificial Analysis 进展指数 v1,它在一条连续的尺度上追踪模型能力随时间的变化。
智能指数新增:
➤ FrontierCode 2.0:Cognition 新推出的真实编码任务私有基准,以仓库维护者是否会合并智能体的改动作为评分标准
➤ Terminal-Bench-Science:70 个智能体科学研究任务,在终端环境中运行
升级:
➤ HLE-Diamond(取代 Humanity's Last Exam):Humanity's Last Exam 的精炼 1000 题版本,推理题与知识题各占一半
➤ AA-Omniscience v1.1:更新后的数据集,移除了饱和题和公开集题目,新增题目,并修订了有歧义或错误的题目
➤ CritPt v2:CritPt v2 的私有、40 题高难度子集,由 CritPt 作者修订,并搭配代码执行工具运行
指数保留:AA-Briefcase、AutomationBench-AA、GDP.pdf 和 Terminal-Bench 4.0
指数移除:GDPval-AA v2.1、SciCode 和 AA-LCR v1.1
主要结果:
➤ Claude Opus 5.5(max)以 58 分领先,高于 GPT-6 Astra(max,57 分)和 GPT-6.1 Sol(max,55 分):Anthropic 和 OpenAI 占据前五名。Gemini 4 Argon(high)以 50 分紧随其后
➤ 开放权重差距从 3 分扩大到 12 分:Kimi K3.1 Pro(权重尚未发布)以 46 分成为顶级开放权重模型。在已发布权重中,DeepSeek V4.1 Flash 1017(max)和 GLM-5.3(max)以 32 分领先——落后领先者 26 分,低于 Claude Haiku 5.5(max,36 分)
➤ 领先模型间的单任务成本相差超过 13 倍:在展示的 10 个最高分模型中,GPT-6.1 Terra(max)每个智能指数任务成本最低,为 0.96 美元,Claude Fable 5.1(max)成本最高,为 13.04 美元
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖