
AirLLM v4.0:4GB显存跑70B模型,Kimi K3也能跑
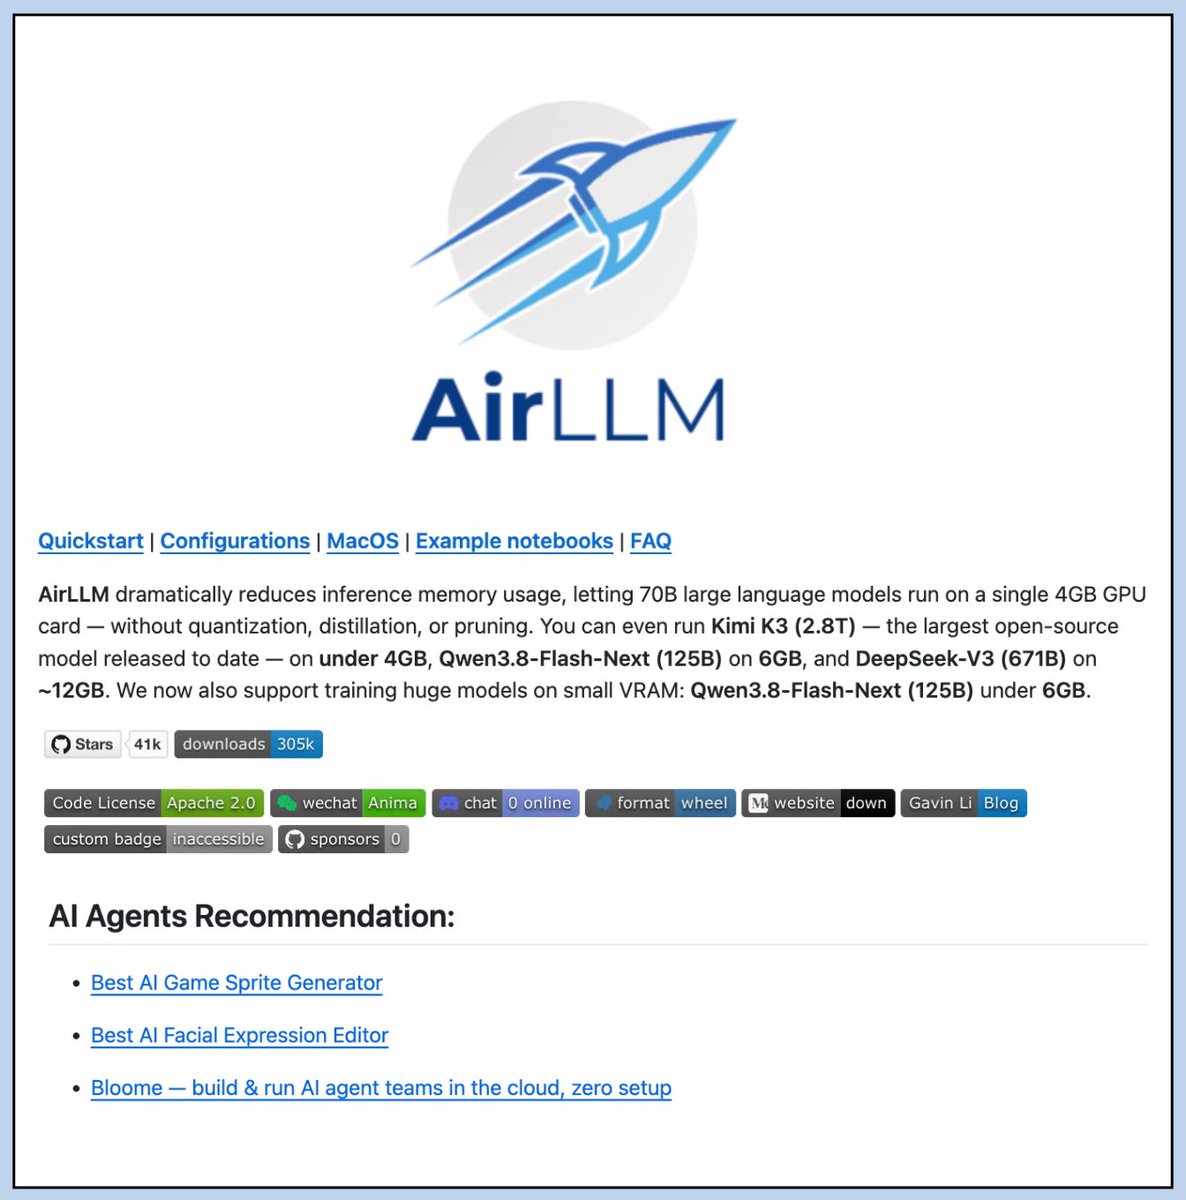
AirLLM 是一个 Python 库,可让 70B 参数的语言模型在单张 4GB GPU 上运行,无需量化、蒸馏或剪枝。
它要解决的问题是可及性。大型开源模型不断发布,但要让全部权重常驻 GPU 内存运行,需要相当强的硬件,这使得没有高端 GPU 或多卡的人无法使用。
AirLLM 的做法是:在推理时,先将原始模型按层分解并逐层保存。这样它就不需要一次性把整个模型常驻在 GPU 内存中。
对于支持的 MoE 模型,它更进一步,只流式加载路由器选中的专家,而不是加载某一层中的所有专家,因为每个 token 通常只使用其中的一个子集。
它支持多种主流模型。你通过 AutoModel 传入 Hugging Face 仓库 ID,支持 Llama、Qwen、DeepSeek、Mistral、Mixtral、Phi、Gemma、ChatGLM、Baichuan、InternLM 以及更新的架构。近期版本已大幅扩展了支持范围。
AirLLM 现在支持 Kimi K3(2.8T 参数),开发者报告在 RTX 6000 Ada 上生成时峰值显存仅为 3.72GB。Qwen3.8 系列模型也已支持,v4.0 还引入了流式 LoRA 微调,部分 Qwen 配置的 GPU 显存需求约为 2–6GB。
此外还有一个可选的压缩功能,采用 4-bit 或 8-bit 分块量化。项目报告称推理速度最高可提升 3 倍,且精度损失有限,但实际效果取决于模型和配置。
代价是速度。从存储流式加载模型权重会降低 GPU 显存需求,但当数据传输主导执行过程时,大模型可能会变得非常慢。
它采用 Apache 2.0 许可证,GitHub 星标约 40.7K,仍在积极维护,v4.0 于 2026 年 9 月发布。
GitHub 仓库地址:
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖