
Hugging Face 开源 Carbon-X DNA 模型,成本仅为 GPT 6.1 Sol 的 1/1800
前沿实验室正在推进 AI 在生物学领域的能力,但他们用广泛却浅显的防护措施,阻止了好人(科学家、学术界、非营利组织、卫生机构……)使用、研究和理解这些技术,而坏人却能轻易绕过这些防护(比如这条推文就被拦截,无法校对 😅)。
这会在未来几年自动造成巨大的不对称和风险,就像网络安全领域一样,尤其是现在前沿实验室正在建设湿实验室(生物学领域的 HF 网络安全场景何时到来?)。
正因如此,我们打造了 Carbon-X,这是目前最好的开源 DNA 模型,通过在 3000 亿 token 的 DNA、英文及交错数据上对 Qwen3-14B 进行中期训练得到。我们还采用了混合分词器,用 BPE 对英文分词,用 6-mer 分词器对 DNA 分词。
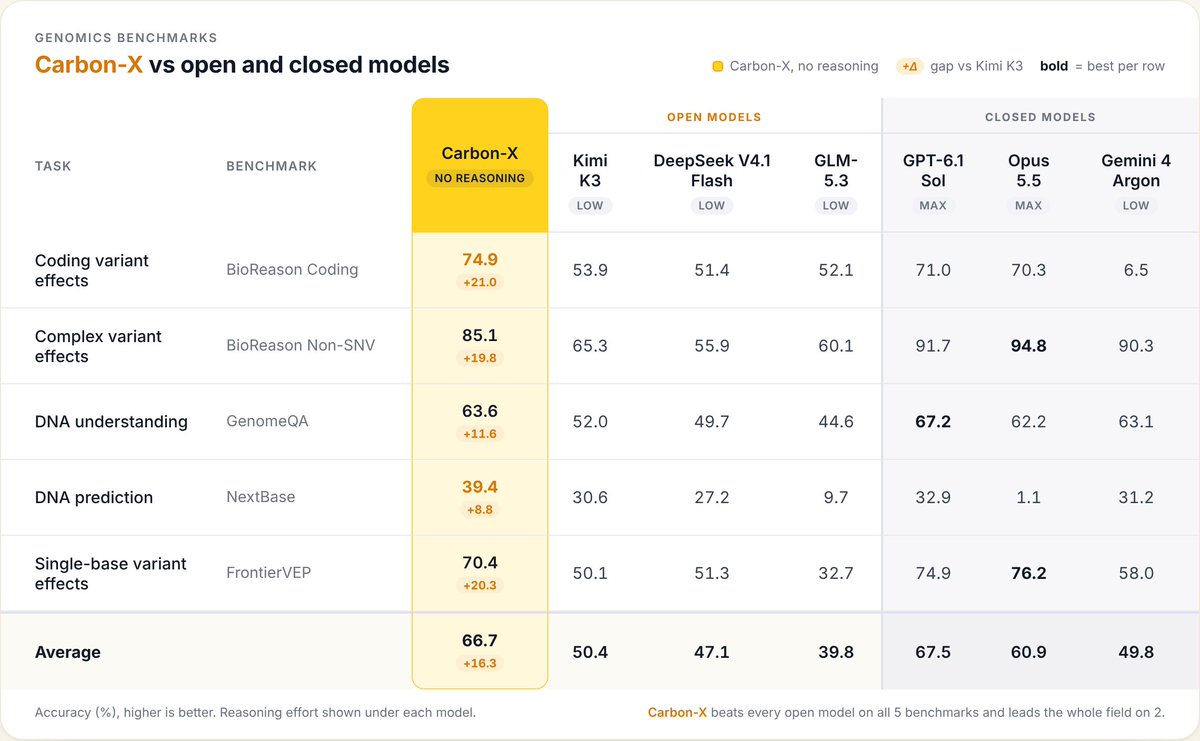
结果是,在五个 DNA 理解与生成基准测试中,Carbon-X 的表现超过了我们评估过的所有开源语言模型。相比 Qwen3-14B,它提升了 27 个百分点,这表明语言模型能从 DNA 训练中获得多大的收益。它的 API 性能也达到了前沿水平,而成本仅为 GPT 6.1 Sol 的 1/1800!
我们希望 Carbon-X 能帮助研究人员以新的方式探索 DNA。将其开源发布,意味着任何人都可以研究它的能力、局限性和风险。让我们把 AI 生物学的前沿技术开源,让它对全世界(而不仅仅是少数几家公司)都安全且有影响力。
基于 Apache 2.0 协议的模型已发布在 @huggingface 上:
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖