
三校教授开源小模型炒股方案:Qwen3-4B复现AURA-4B
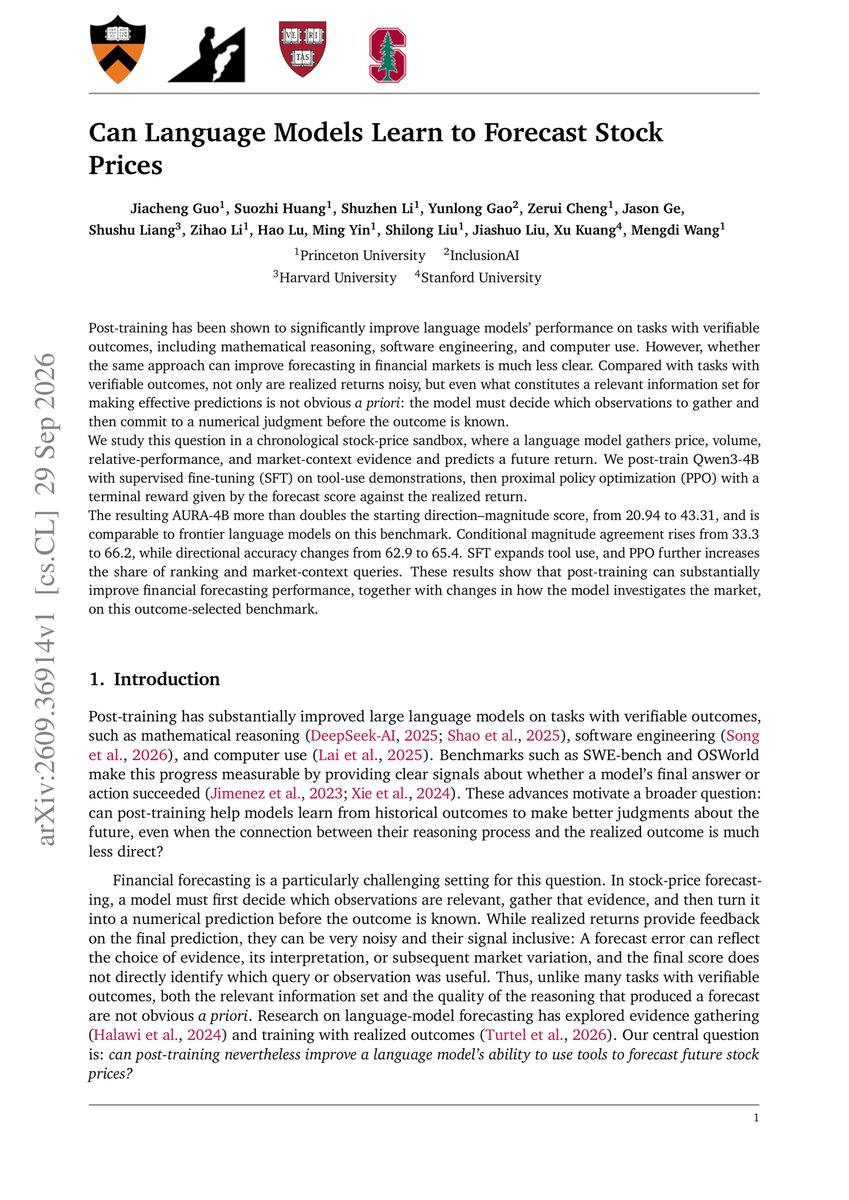
斯坦福、哈佛和普林斯顿的教授们拿了一个免费的小型 AI 模型,教会它预测市场走势。它研究了 499 只美国股票 13 年的数据,给它一个股票代码,它会自己调取图表并预测下一步走势。以下是他们的构建步骤:
第一步 → 他们采用了 Qwen3-4B,这是一个免费的开源模型,并为其配备了 9 个工具:K线图、技术指标、股票排名、行业和市场数据。
第二步 → 第一课:3631 个完整的股票分析示例,让它学会在做出预测前该调取哪些数据。
第三步 → 第二课:在 2011-2023 年的数据上进行约 3200 次预测练习,每次都根据实际价格走势进行评分,然后在 2024-2026 年的数据上进行盲测。
第四步 → 你的版本:将下面的提示词复制到 Claude Code 中,它会阅读论文,在免费的 Yahoo 数据上重建这 9 个工具,并设置好 Qwen3-4B。
第五步 → 最厉害的部分:它运行相同的盲测,对模型隐藏 2024-2026 年的数据,并将其与 GPT-5.6 和一个简单的动量规则进行比较。
结果是:一个真正可以在你电脑上进行交易的免费小型模型,使用了世界顶尖大学的相同方法构建。现在就试试。然后阅读下面的文章,了解如何搭建最危险的交易平台:
论文:
提示词:
“在我的电脑上重建普林斯顿大学论文《语言模型能学会预测股票价格吗》(arXiv 2609.36914,AURA-4B)中的股票预测设置,并向我展示免费的 Qwen3-4B 在训练前后的对比。这是研究,不是交易:永远不要连接券商或下单。完成的标准是:一个 ~/aura 文件夹,其中包含 (1) SPEC.md,一份对论文方法的简明总结:9 个工具、任务格式、预测周期、评分 S = D x M / 100、训练/测试划分以及训练步骤;(2) 一个基于免费 Yahoo Finance 数据的可用预测环境;(3) 一个在 2024-2026 年数据上的盲测结果表:简单动量规则、基础 Qwen3-4B,以及(如果我选择训练)我训练后的模型,并与论文中的数据(基础 20.94,动量 42.00,AURA-4B 43.31)并列;(4) 一份简明的英文报告。当某一步不需要我参与时,继续进行。
方法:
- 先阅读论文(https://arxiv.org/html/2609.36914,必要时看 PDF),并在公开数据允许的范围内尽可能遵循它。如果论文中有不清楚的地方,自行做出选择,并将选择记录在 SPEC.md 中。
- 数据:通过 yfinance 从 Yahoo Finance 获取 S&P 500 股票数据。每个工具只能看到截至预测日期的数据。不能有未来数据,通过测试检查这一点。在报告中注明,今天的 S&P 500 名单不包括已退市的股票(幸存者偏差)。
- 模型:来自 Hugging Face 的 Qwen3-4B。选择在我的机器上运行它的最快方式(Ollama、llama.cpp、Mac 上的 MLX 或 transformers),并告诉我选择了哪种。如果完整测试太慢,先从 40 个测试任务的快速模式开始。
- 先运行免费部分:动量基线和基础 Qwen3-4B 的盲测。
训练(可选,需要费用,先问我):
- 步骤 A,示例:论文使用了 3631 个由强模型编写的示例。估算我所选模型的 API 费用,展示出来,并等待我的同意。从环境变量中读取任何 API 密钥;永远不要让我在聊天中粘贴它。
- 步骤 B,微调加 RL(论文使用了 SFT,然后是 PPO):告诉我需要什么 GPU、最便宜的租赁选项和预估费用,并等待我的同意。给我在那里运行的确切命令。
- 训练后,重新运行相同的盲测并更新表格。
规则:标记任何你无法确认的内容。如果我的结果与论文不同,说明这一点并解释可能的原因;不要在测试期间进行调整。非财务建议。最后以三个标题结尾:结果、费用、我需要你做什么。”
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖