
开发者锐评 DeepSeek DeepInfer 推理侧实现:开源仓库价值有限,核心设计思路解析
给一点 Deepinfer推理侧的速度锐评
1. 感觉 git repo 本身,对我们这样研发来说意义不太大,有一点点吧,但是好些东西没开。但是论证了我 kern 的想法,per model per repo 。
2. 精华本身在 zhihu 那篇文章,这篇文章很有价值, ds 内部的并行,decode 侧就还是经典的 wideep,ep64 什么的。
有价值的就在几个 load balancer,第一个是分桶(这个其实是比较生产的),不知道开源 router 有没有人做,但生产来说,其实之前 together 就探索过一下。
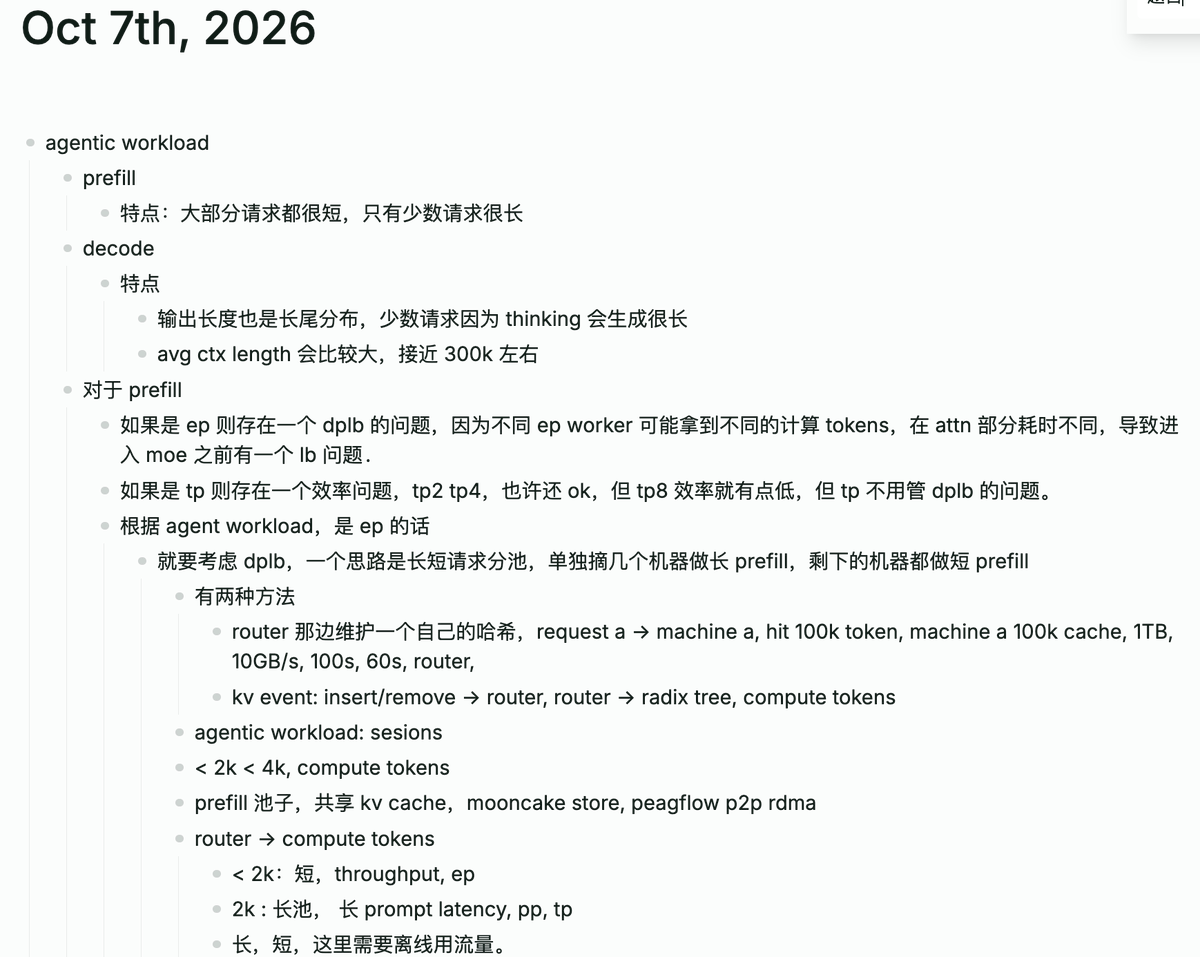
prefill 的路由策略很有意思,不做任何的 cache aware,靠池化兜底。 dp group 直接用 compute tokens 作为负载 平衡的指标,dp 组内,也是。这个有点什么的味道,我想不起来了。可能和 hash 那边的一些东西有关,maybe 是,bitmap 什么的,我只是说思想好吧。
fifo,这里有个有意思的,它也做了一个估计器,其实前不久我也做了一个(只不过链接失效了hh),我当时是想给 pp 做的,但是我觉得无论 ep pp,这个思路是一致的,不固定 chunk size,然后固定“耗时”,总之就是一个离线你先跑出来嘛,然后给个表,然后让 scheduler 去估到合适的时间,组 batch。
当然我有一个想法是,prefill 到底是 pp 还是 ep,当然现在模型训成 每一个 Layer 都不一样的,那天生也就对 pp 不友好,那也没招。但是 ep 要完整做完 ds 这一套,需要不少流量和 prefill worker。总的来说在中小部署我看好 pp(几个 prefill worker 这种),大部署我才看好 ep。
decode 和我想的也差不多,就是一个 kv cache + num running 的组合是吧。当然具体怎么调配就是一个 case by case 的事情。
eplb 呢,就是冗余换 lb 吧。不过有个在线的 eplb,不知道开源出来没有。这里的 trade off 就是,eplb 会占用更多显存是吧,但是呢它也能提升吞吐,而且越复制收益越小,所以要找到一个比较合适的点。也是 case by case 的。
然后是 router 的pd 动态扩缩容,prefill 还是 整体compute tokens,deocde 是 num running。
kv cache 呢就是 3fs,然后 3天的 ttl,能换到 0.5 - 1% 的命中率。kv cache 管理由 decode 主导?这样输出也能被 hit。
关于 I/o,精华是这句,换入从 shm 到 HBM 在 engine 进程内的线程里做,目标是实现逐层 H2D (Host-to-Device) 传输与前向计算重叠,由于 CUDA copy engine 对于 KVCache Block 细粒度的拷贝性能不佳,换入使用 GDR 实现,用 RDMA 网卡就能打满 PCIe 带宽,并且不占 SM。
这个我有空后面再讲吧。
dspark 变长验证,这个真上了,挺好的。
异步调度,先忽略。
ds弄了一个结构化输出库,good!
为了防止说我在蹭,我截个图,我之前思考过的路由策略,开源我的 thinking content !