
Cortex 让 LLM 把上下文经验写进模型参数
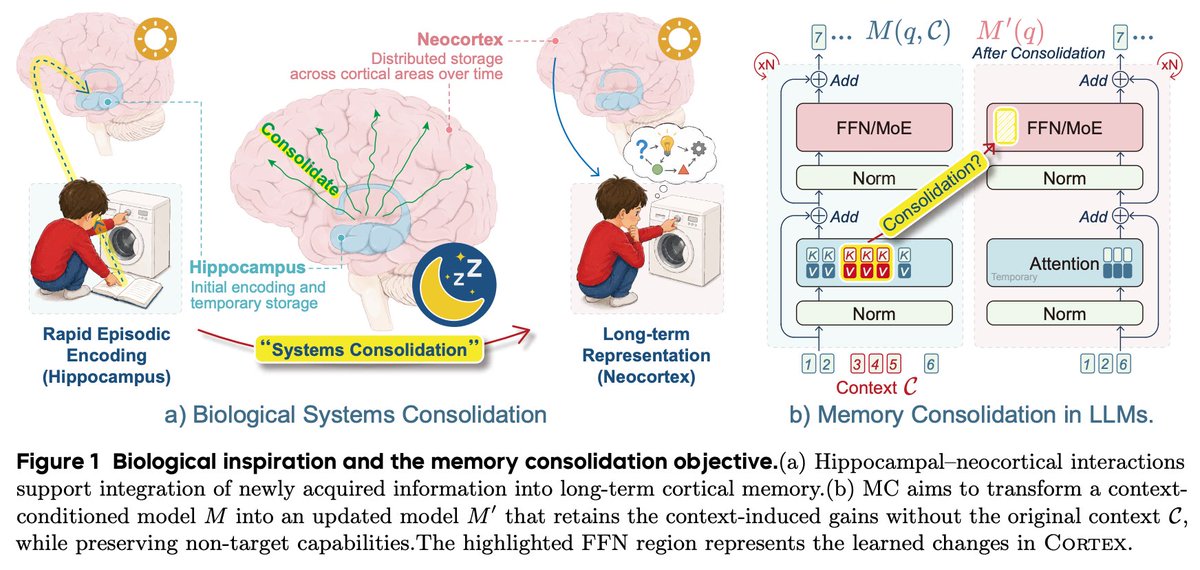
人类智能的成长建立在经验积累之上。我们获取知识、打磨技能、修正信念,并把学到的东西带入未来的各种情境。🤔 大语言模型智能体也能做到同样的事吗?🧠 在此介绍我们与字节跳动 Seed 团队合作的新研究《Cortex:将上下文巩固为参数记忆》。#Cortex #知识编辑 #LLM #记忆
我们的灵感来自生物系统的记忆巩固机制:海马体快速编码新体验,再通过与新皮层的互动,将这些体验整合进长期记忆。大语言模型智能体已经能从上下文中的文档、示例和反馈中获益。但一旦上下文被移除,这些收益并不会自动保留下来。
借助 Cortex,我们研究如何将这些收益巩固到模型参数中,让它们在原始上下文之外依然有用,同时不影响目标改动范围之外的能力。外部记忆是把信息存起来供日后检索。我们探索的是另一条互补路径:把经验带来的有用效果整合进模型本身。📄 论文:💻 代码(即将发布):
💡 可以巩固哪些内容?经验可能带来不同类型的改变:
• 新增:获取新知识或新技能。
• 修正:更新过时的事实或行为。
• 抑制:学会不输出特定信息或回应。
我们把这些在上下文中指定的知识、技能和行为改动统一归为「记忆巩固」:在移除上下文后找回上下文带来的收益,同时不影响目标改动范围之外的能力。
⚙️ Cortex 是如何工作的?我们围绕三个问题来搭建这套方法:学什么、写到哪里、以及如何让所学内容在没有原始上下文的情况下也能发挥作用。
学什么:预演未来的使用场景。Cortex 围绕「上下文本应发挥作用」的场景构建训练样本。在大多数任务中,它会生成前瞻性问题,并在有上下文可用的情况下作答。
写到哪里:写入前馈网络。我们探索了两种机制:低秩权重更新(Synaptic)和额外的非线性特征通道(Structural)。两者都可以折叠进标准模型层中。
如何用:让带上下文的模型教不带上下文的模型。更新前的模型本身充当教师。它接收原始上下文;学生模型则学习在没有上下文的情况下作答。我们同时对齐两者的输出分布和内部表征,且只训练新引入的参数。
举例来说,教师模型可以查阅陌生 API 的文档,再给出解决方案。学生模型从这种监督中学习,这样即便文档被移除,它也能使用这个 API。
🔬 怎样才算巩固成功?学会新内容只是挑战的一部分。我们还需要衡量模型原有能力受到了什么影响。我们的测试集覆盖五大任务族:
• 智能体经验:复用过往经验中有用的策略。
• 新 API 学习:使用陌生的
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖