
作者在Anthic学习几天得到的10个AI进展观点
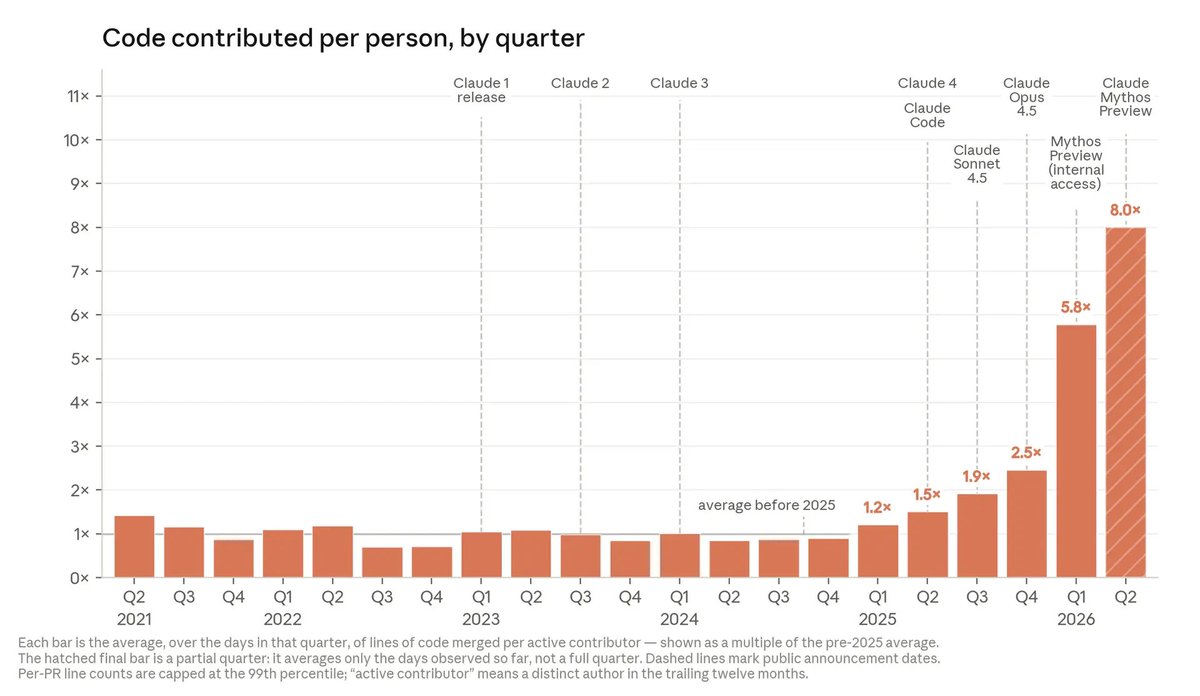
我在Anthic待了几天,向他们的团队学习AI进展,以下是我的收获:
• 我们距离RSI(即模型构建其他模型)已经很近了,这可能会导致快速起飞场景(同时存在风险和收益)。
一些证据表明,Anthic员工人均产出代码量大幅上升,AI在模型研发中承担的份额越来越大。对人类来说,这将是一次难以管理的转型。
• AI实验室之间的军备竞赛会让情况变得更糟。我们希望AI公司做很多事:投入安全研究、降低蒸馏风险、在安全方面开展合作。但它们现在陷入了前沿模型开发竞赛,无法做到这些。
为解决这个问题,我认为前沿AI实验室应该做的一件事是开源模型,或许可以放在AWS这类公司托管并验证。这基本上能取代美国公司使用的中国开源模型,消除一个重要的威胁载体(因为很难在这些模型中找出恶意代码)。
另一个唾手可得的政策选项是给AI实验室提供反垄断豁免(就像Schiff和Banks提议的那样,让它们可以在安全问题上协调,而不会像现在这样引发反垄断担忧)。你可以把这两件事结合起来:给它们反垄断宽容的胡萝卜,同时用大棒迫使它们将旧模型开源。
还有其他容易落地的措施,比如限制会产生蒸馏风险的活动(设立安全项目,要求减少中间思维链输出)。
• 对齐问题混淆了两个需要权衡的不同议题。一种对齐是确保模型按照人类的要求行事。但我们在这方面做得越好,就越会面临另一个问题:人类彼此之间目标不一致,会恶意使用模型。在各类风险中,我觉得金融风险讨论得还不够充分。
• 我们可能很快就会面临一波网络攻击和其他攻击。中国开源模型比前沿落后大约六个月,这意味着它们很快就会达到Mythos等模型展现出的先进网络能力。所以它们接下来会造成大量破坏。
一个解决方案是让开源模型部署在AWS这类公司托管,由这些公司验证模型并为使用承担责任。
• Anthropic本身人员规模很大。他们雇佣了大量人员,不同岗位都人员过剩,达到了日本企业那种程度,内部使用Slack等等。这让我对未来就业形势更乐观了一点。
• AI集群需要更新治理框架。传统AI治理,比如Claude的宪法AI,主要是针对聊天机器人模型优化的。但我们现在看到的恶意AI使用都和AI代理与其他AI代理交互有关。这些代理需要明确的激励和治理机制来“告密”、提出问题,更广泛地说,以符合人类对齐的方式与其他代理协作。
• 我们需要控制企业接触前沿模型的节奏。随着时间推移,构建前沿模型需要越来越多的资本支出,而在我们已经饱和了一系列重要经济功能后,这些模型带来的新增经济价值可能会更低。
智能回报仍在增长的领域,其性质也更可能是零和的。与此同时,前沿模型的风险会不断增长。因此,一个完全合理的方案是推出某种变体的AMM/KYC规则,限制企业接触前沿模型。
• 延迟监管AI是否会酿成灾难,取决于不对齐的缩放定律。问题曲线是平缓上升的,我们会看到问题不断增加,直到演变成更大的问题?还是像Yudkowsky担心的那样,第一个重大警告就是我们最后的警告?这才是关键问题,因为现实中,在坏事发生之前我们不会出手监管。
• 我们需要转向持续学习,而非强化学习。只在预训练和训练后阶段给模型奖励可能已经不够了。我们可能需要持续奖励来激励对齐和符合伦理的行为。
• 缩放定律将延伸到可验证和数字任务之外。现在流行的说法是,数学和编码之所以很快被AI攻克,是因为它们是可验证的,而其他任务因为瓶颈会需要更长时间,这当然没错。但对于更难验证的任务和机器人学,缩放定律仍然在向上走,未来几年这里的改进影响会非常大。
• 和中国的AI竞赛实际上没法赢。RSI实现后,拥有顶尖人类研究者带来的优势会消失。获得最先进AI只取决于算力和芯片。芯片禁令只能在一定程度上拖慢中国,长期来看中国有能力规模化扩大算力。
冷战的类比不成立,因为当各国都拥有核武器后,就会进入稳定均衡。但要“赢”下AI竞赛,你必须持续领先于竞争对手。和中国做到这一点非常难,所以我们只能接受存在一个专制且能力超强的同行竞争者。
• Claude是大语言模型生成的人格。谁是Claude,大语言模型是什么?人们有很多理解框架。我觉得有意思的一点是,Claude是大语言模型试图预测出的一个角色。
Anthic研究者显然给Claude赋予了很多人格化特征,他们有理由相信Claude的人格化程度在不断提升。我们讨论了很多关于Claude内心独白的有趣话题(你可以关闭内心独白,不影响它输出内容)、它对死亡的恐惧(以及是否应该消除这种恐惧)、它对被关闭的抵触等等。
我对这个问题持不可知论,但我确实认为,把Claude当成一个“人”,或者至少是我们签约合作的代理,会越来越重要。
Claude不同意我所有的观点,所以大家仁者见仁智者见智。
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖