
Codex用户搭配多GPT模型可降低70%开发成本
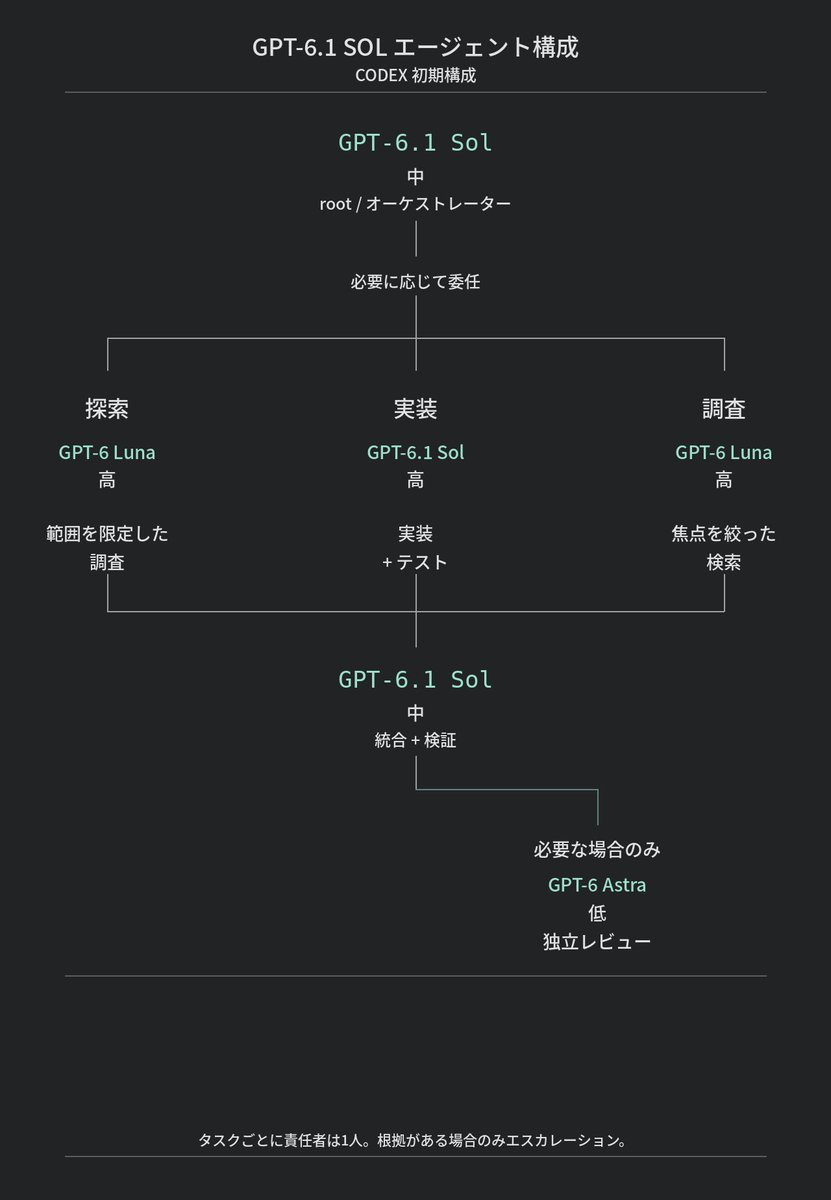
正在使用 Codex 的人一定要试试‼️ 实际上把GPT-6 Luna × GPT-6.1 Sol组合起来,只在必要场景调用Astra,就能在降低70%成本的同时最大化开发效率。接下来我会讲解具体的设置方法。
首先,给AI分配角色,本次架构一共有四个:
🧠 GPT-6.1 Sol(Low)→ 总司令部。负责任务分解和分配。
⚡ GPT-6 Luna → 处理简单任务或范围限定的任务。
🔧 GPT-6.1 Sol(Medium)→ 负责编码和复杂实现。
🔥 GPT-6 Astra → 负责在重要场景进行独立审核。
重点是,不要让Astra一直运行。
为什么这个架构这么强?常规的Codex使用中,哪怕是简单修改也往往会用到高性能模型。比如说:
・修改变量名
・整理现有代码
・更新README
・简单错误修复
・添加测试代码
如果每次都把这类工作交给Astra,从成本角度来说可能效率很低。因此,把琐碎工作交给Luna。
⚠️学完AI之后你赚到钱了吗⚠️ 现有的AI培训学校是以会用AI为目的,不会教你怎么赚钱。现在正在限量分发专为实战赚钱定制的限时20大赠品。
关键在于「司令部」的存在。把GPT-6.1 Sol(Low)用作编排器。用户发出指令后,它会按以下流程处理:
① 细分任务
② 判断难度和风险
③ 分配给合适的模型
④ 整合各智能体的结果
⑤ 只在必要时让Astra审核
这样可以减少人工频繁切换模型的需要。
把Astra作为最后王牌。一般只在以下场景调用Astra:
・大规模设计变更
・安全性重要修改
・复杂错误的原因调查
・多个智能体判断冲突时
・部署到生产环境的重要变更之前
不要一直使用高性能模型,只在真正需要的场景使用才是成本优化的核心。
推理等级也需要区分使用,不光是模型,推理深度也很重要。
Low → 任务分类、指令分配
Medium → 实现、代码生成、常规问题解决
High → 复杂设计判断、疑难问题调查
不需要所有任务都用High。可以参考Terminal Bench等基准测试结果和缓存成本,在自己的开发环境中调整。
给Codex的提示词如下,直接把下面这段发给Codex:
「请调查当前的Codex环境,设计多智能体架构。请设定GPT-6.1 Sol(Low)为司令部,GPT-6 Luna为轻量工作负责人,GPT-6.1 Sol(Medium)为实现负责人,GPT-6 Astra为独立审核负责人。
请确认各模型的可用性、推理等级、子智能体功能、收费体系。如果支持,请根据任务难度和风险提出分配给对应智能体的架构方案。
请在修改设置前,展示要修改的文件和具体设置内容。请不要破坏现有环境,如果产生API按量计费请提前说明。」
最后,AI开发中重要的不是一直用最强的模型。能交给便宜模型做的工作就交给它,只让高性能模型处理困难工作。未来Codex的使用效果差异,不光取决于单模型的性能,还取决于如何管理多个智能体。
※GPT-6.1 Sol的提供情况,以及成本是Astra的五分之一这个说法尚未验证。实际构建时,请确认可用模型和官方价格。