
实用的生产级AI应用仓库蓝图
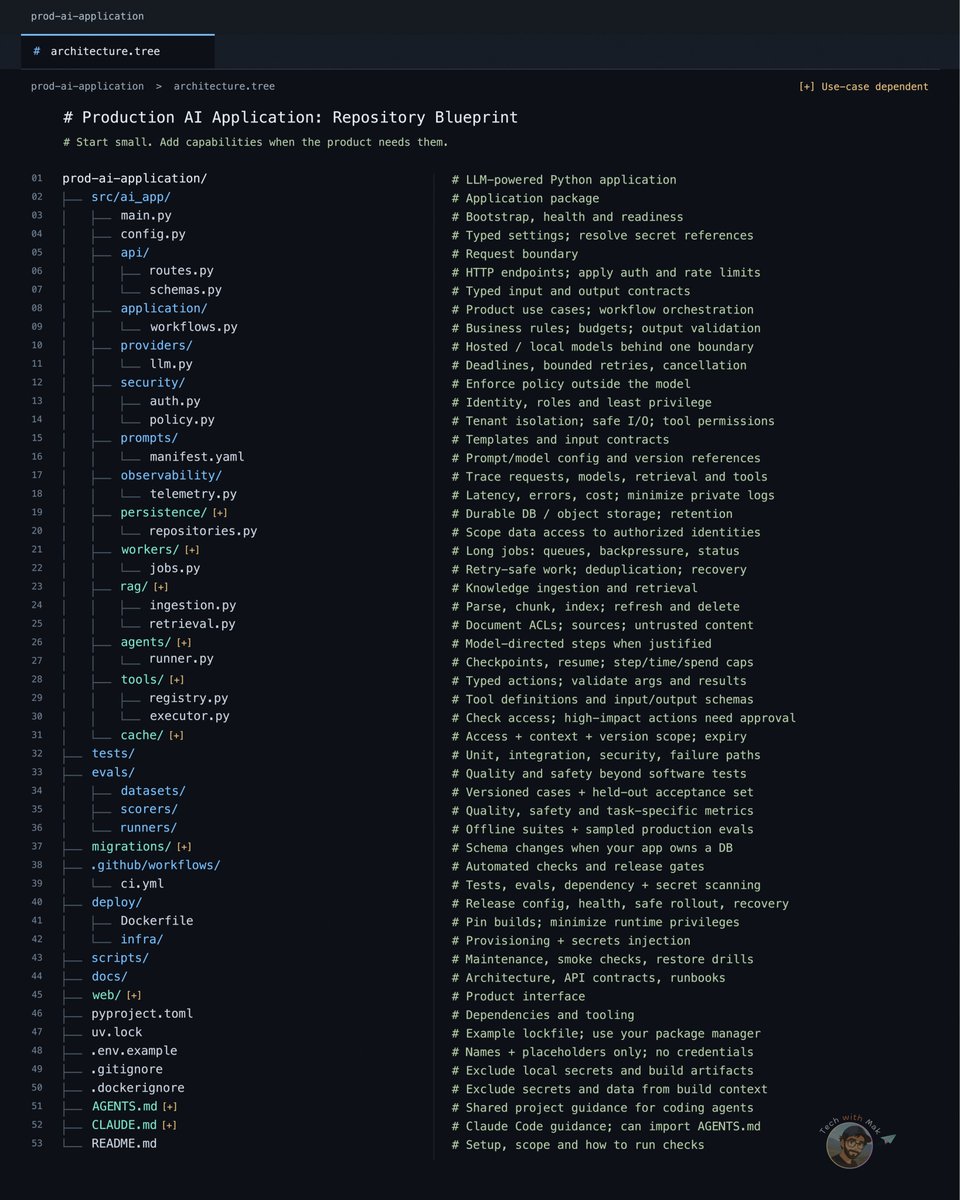
这绝对是生产级 AI 应用最实用、最贴近实际的仓库蓝图之一。它涵盖了大语言模型周边的全部工程工作,从请求处理、模型集成到安全、可观测性、评估和部署。
每个部分都有清晰的职责划分:
`api/`——请求处理、类型化 schema、认证和速率限制。
`application/`——工作流、业务规则、预算和输出验证。
`providers/`——模型集成、截止时间、有限重试和取消。
`security/`——身份、租户隔离、访问控制和工具权限。
`prompts/`——模板、输入契约、模型配置和版本引用。
`observability/`——请求追踪、延迟、错误、模型用量和成本。
`evals/`——版本化数据集、质量检查、预留验收测试和抽样生产评估。
`tests/`——单元测试、集成测试、安全测试和故障路径测试。
`deploy/`——构建、基础设施、健康检查和安全发布。
RAG、智能体、缓存、工具执行、持久化和后台工作者都被组织为独立的、依赖用例的能力模块。有些应用从第一天起就需要这些能力。重度依赖检索的产品可能需要 RAG,而智能体应用可能非常依赖工具执行和编排。该结构可以同时容纳这两种情况,不会强制所有应用使用同一套架构。
模型调用可能会超时。用户可能请求他们未授权访问的数据。修改模型和提示词可能会降低回答质量,但不会导致任何单元测试不通过。应用需要处理这些情况,强制执行权限,并给工程师提供足够的追踪、测试和评估工具,以便在部署前后识别问题。
仓库结构本身不会自动完成这些工作。它只是给这些职责在代码库中安排了清晰的位置。从小处起步,当产品需要时再添加能力。
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖