
@techNmak 讨论推理工程被严重低估
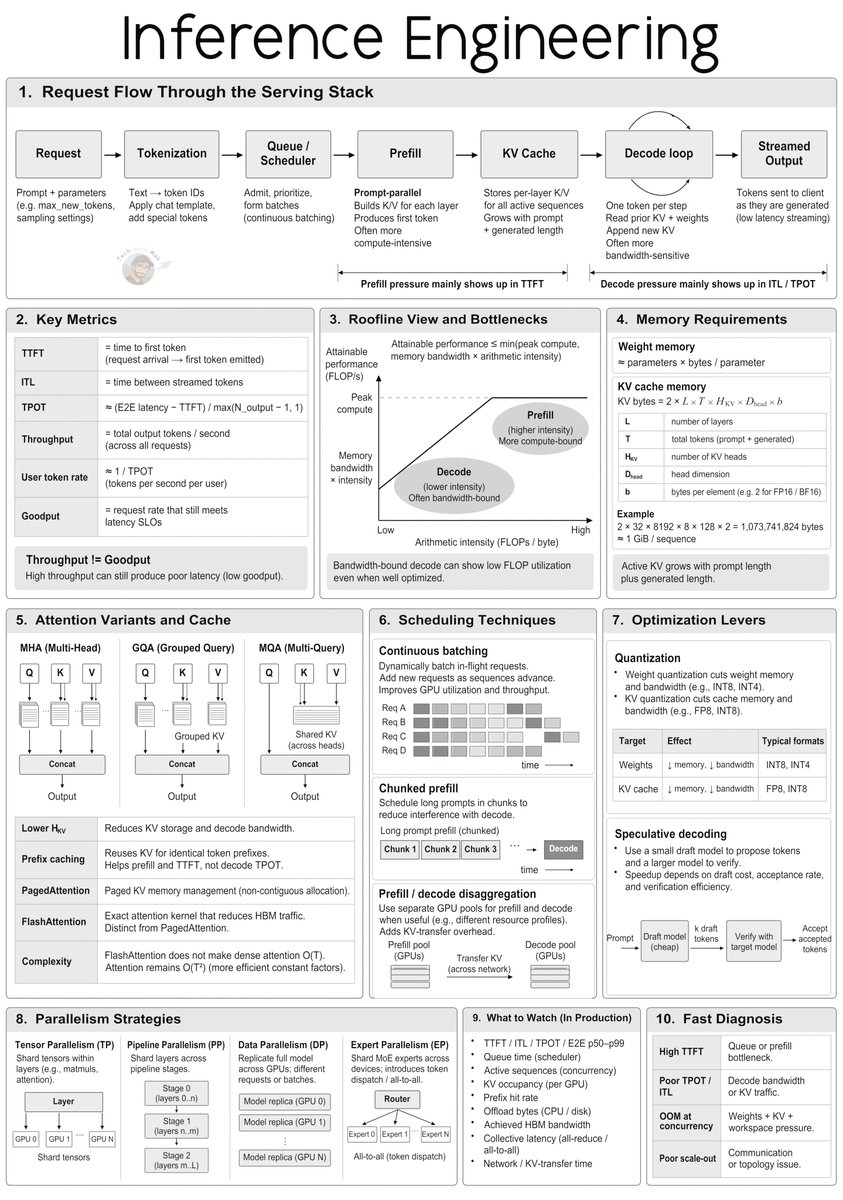
推理工程正在成为人工智能领域最重要的技能组合之一,我认为很多工程师仍在低估它的重要性。训练吸引了绝大多数关注,因为模型就是在这里创建的。
但当模型需要处理真实流量时,就会出现另一组完全不同的工程问题。请求的输入提示长度、输出长度、缓存复用、到达时间和延迟要求各不相同。此时你需要处理排队、批处理、KV缓存容量、GPU显存、调度、核函数效率、通信和尾延迟。
首先需要明白,推理不是单一同质的工作负载。Prefill 处理输入提示并生成会在生成阶段复用的KV状态。跨越提示词的很多操作可以并行执行,因此Prefill通常有更高的计算密度,可以充分利用GPU算力。
Decode则不同。每个序列自回归推进,通常每个解码步骤生成一个新token。系统会重复读取模型权重和不断增长的KV缓存,而每个token对应的计算量相对较小。在实际的服务批大小下,Decode会严重受限于内存带宽。
这种Prefill/Decode划分解释了现代推理工程的很多内容。FlashAttention在计算精确注意力的同时,减少了HBM和片上SRAM之间的读写。PagedAttention解决的是另一个问题,它按块管理KV缓存内存,不需要每个序列占用一块大的连续内存,减少了内存碎片化,让动态增长的缓存更容易管理。
MQA和GQA对比标准多头注意力减少了键/值头的数量,这降低了KV缓存的存储需求,也减少了解码阶段需要移动的KV数据量。
调度同样重要。持续批处理允许请求在生成过程中进出活跃批处理,不需要强制固定一组序列一起完成。分块Prefill把大的Prefill拆分成更小的块,可以和Decode工作一起调度。这让调度器能更好控制长提示和已运行生成任务之间的干扰。
前缀缓存从另一个方向解决冗余工作。如果多个请求共享已经处理过的前缀,对应的KV状态可以直接复用,不需要重新计算这部分提示。重要的是,这节省了Prefill的计算量,但不会让新输出token本身的生成更快。
接下来是内存。模型权重只是GPU显存占用的一部分。随着活跃序列保留更多token,KV缓存会不断增长。对于传统的全上下文注意力,它的大小取决于层数、缓存token数、KV头数、头维度和每个缓存值使用的字节数。这就是MQA和GQA对推理服务如此重要的原因之一。更少的KV头意味着每个token占用更少缓存。
量化会(原文此处截断)
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖