
Reflection AI发布Beam MoE大语言模型(501B-parameter)
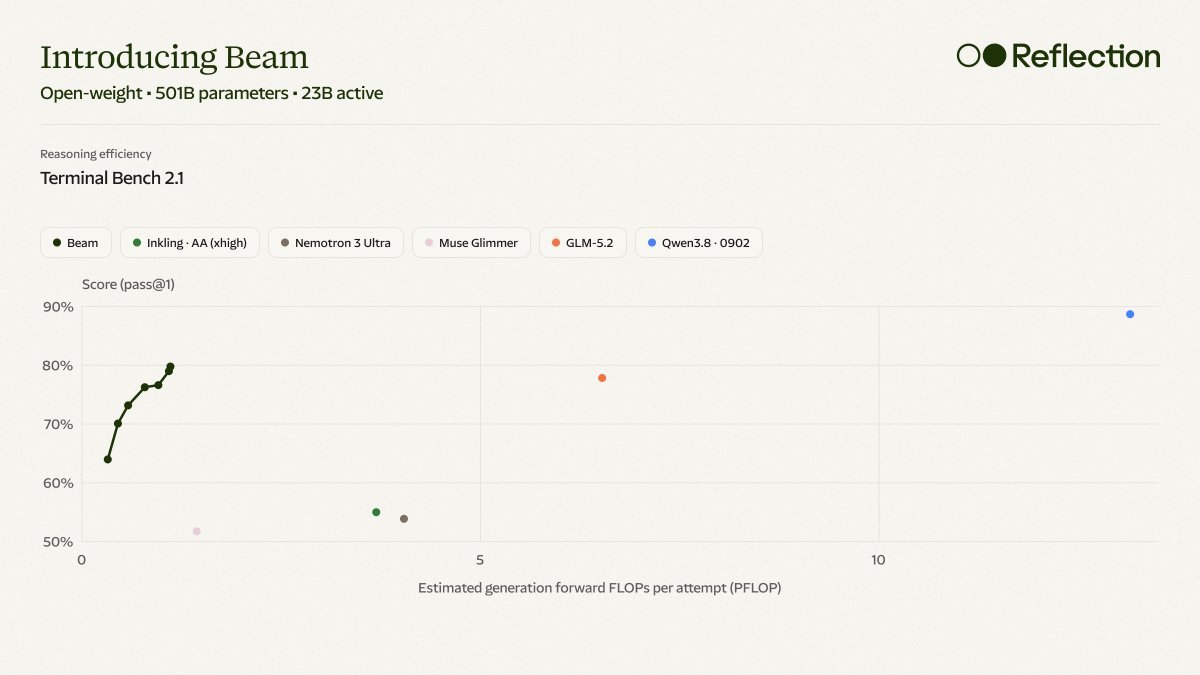
Reflection 宣布推出 Beam:一个总参数 501B、激活参数 23B 的模型,完整权重计划本月发布。它具备前沿能力,而且这个模型的效率简直太棒了!
Beam 是从头训练的,目标是编码、推理和智能体任务。Reflection 称它的推理效率比 GLM 5.2 高 3-4 倍,比同级别的领先西方开源模型效率高出 4 倍以上。在四周内完成了 24T 预训练 token 的训练,随后在 10500 块 GB300 上进行了四周的强化学习。在 Terminal Bench v2.1 和 SWE-bench Verified 上分别取得了对应成绩,在 SWE-bench Verified 上得分为 80.9。
但我还是要说:看看它的效率,尤其是在 Terminal bench v2.1 上的表现!祝贺发布。未来还会有更多西方开源模型推出。
这对美国开源 AI 生态来说是一个重大时刻 🇺🇸 @reflection_ai 即将发布 Beam:一个激活参数 23B/总参数 501B 的 MoE 模型,性能可与 GLM 5.2 媲美,接近 Qwen 3.8 Max,尺寸约为后者的 1/4。在 DeepSWE 得分为 44,Terminal-Bench 2.1 得分为 80,CritPt 得分为 15,推理效率比同等能力的开源模型高出 4 倍。
它拥有强大的推理预训练基座,还是开源记录中规模最大的持续高算力强化运行之一。具备前沿编码和智能体能力,效率大幅提升,权重开源。出发吧!🚀
Reflection 创始人谈打造西方版 DeepSeek Reflection 即将发布它的首个开源权重 AI 模型 Beam,目标是成为西方版 DeepSeek。Beam 从零开始训练,专为编码、推理和 AI 智能体设计。
Reflection 的基准测试显示,它能和最强开源模型扳手腕,而且 token 经济效率大幅提升。为了庆祝 Beam 亮相,节目邀请到了 Reflection 的联合创始人:CEO @MishaLaskin,他曾领导 Google Gemini 的奖励建模,还有 CTO @real_ioannis,他曾参与开发 AlphaGo 和 AlphaZero,之后领导了 Gemini 的 RLHF 工作。
Reflection 已经从英伟达、红杉和光速等投资方那里筹集了 46 亿美元。节目讨论了为什么中国实验室在开源 AI 模型领域领先,Reflection 是如何打造 Beam 的,以及为什么创始人认为企业和国家会越来越想要控制自己的模型。
我问到他们计划如何从开源权重 AI 中赚钱,开源能否让这些系统更安全,以及 Reflection 下一步的计划。时间线:
00:00 开源模型为什么崛起
01:06 租赁 vs 自有智能
03:40 开源模型迎头赶上
05:53 为什么中国引领开源 AI
08:03 介绍 Beam
10:05 扩展强化学习
14:09 从零训练
16:04 安全、对齐和开源
32:29 Reflection 的起源故事
37:32 如何靠开源模型赚钱
42:33 垂直整合和算力
48:45 合作和分发
56:46 Reflection 的下一步
感谢节目首席赞助商:@Atlassian、@meetgranola 和 @mercury。
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖