
两款Qwen本地模型,速度性能各有优劣
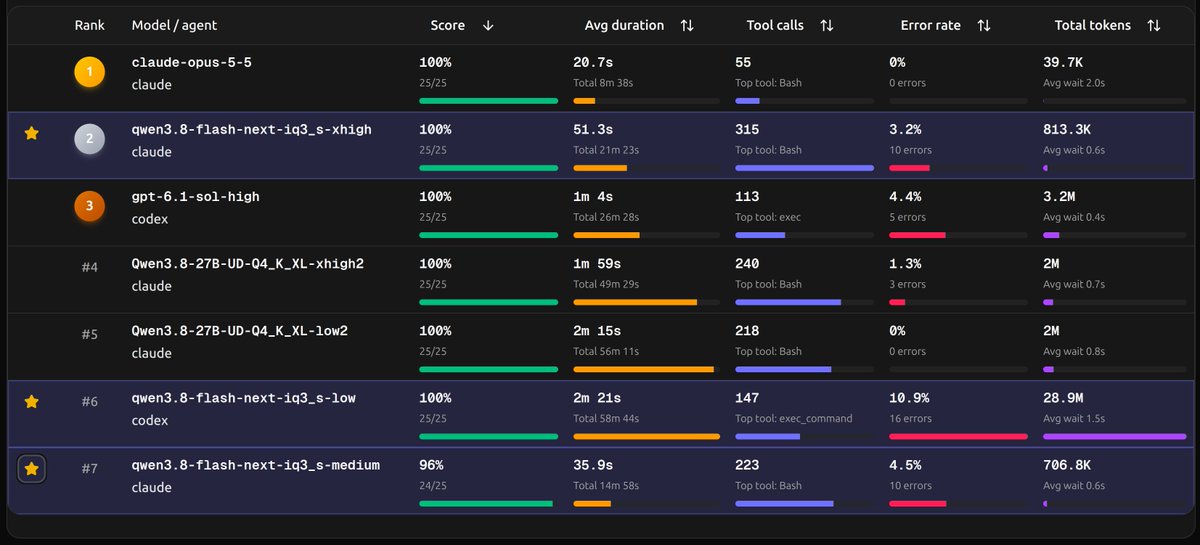
针对“Strata + Qwen3.8-Flash Next 和 Qwen3.8-27B 到底该用哪个?”这个问题,给本地大语言模型爱好者分享一下 ts-bench 的基准测试结果。
● 备注
・很惊人的是,Strata + Qwen3.8-Flash Next 的速度比 llama.cpp + 27B 快一倍以上。虽说是 MoE 模型,但在只有 32GB VRAM 的 RTX 5090 上能跑出这个速度,真的非常厉害。
・另一方面,性能方面,IQ3_S 量化会导致性能略有下降,和 Claude Code 搭配使用时,medium 设置下无法全对,low 设置下会陷入循环无法完成运行。而 27B 在 low 设置下也能得到满分。
・和 Codex 搭配使用时,看起来会消耗非常多额外的 token,但在 low 设置下也能拿到满分。
● 结论
・推荐 Qwen3.8-27B(4bit)的人群
① 需要并行推理
② 速度慢没关系,想要稳定性
・推荐 Strata + Qwen3.8-Flash Next 的人群
① 不需要并行推理
② 觉得 27B 不够用的人(如果需求是 27B 以上,推荐 IQ3_S 及以上的 xhigh)
如果用 Strata 做 4bit 量化也能有这么快的速度,那就完美了。