
通义千猜工具调用9种方案5个引擎实测对比
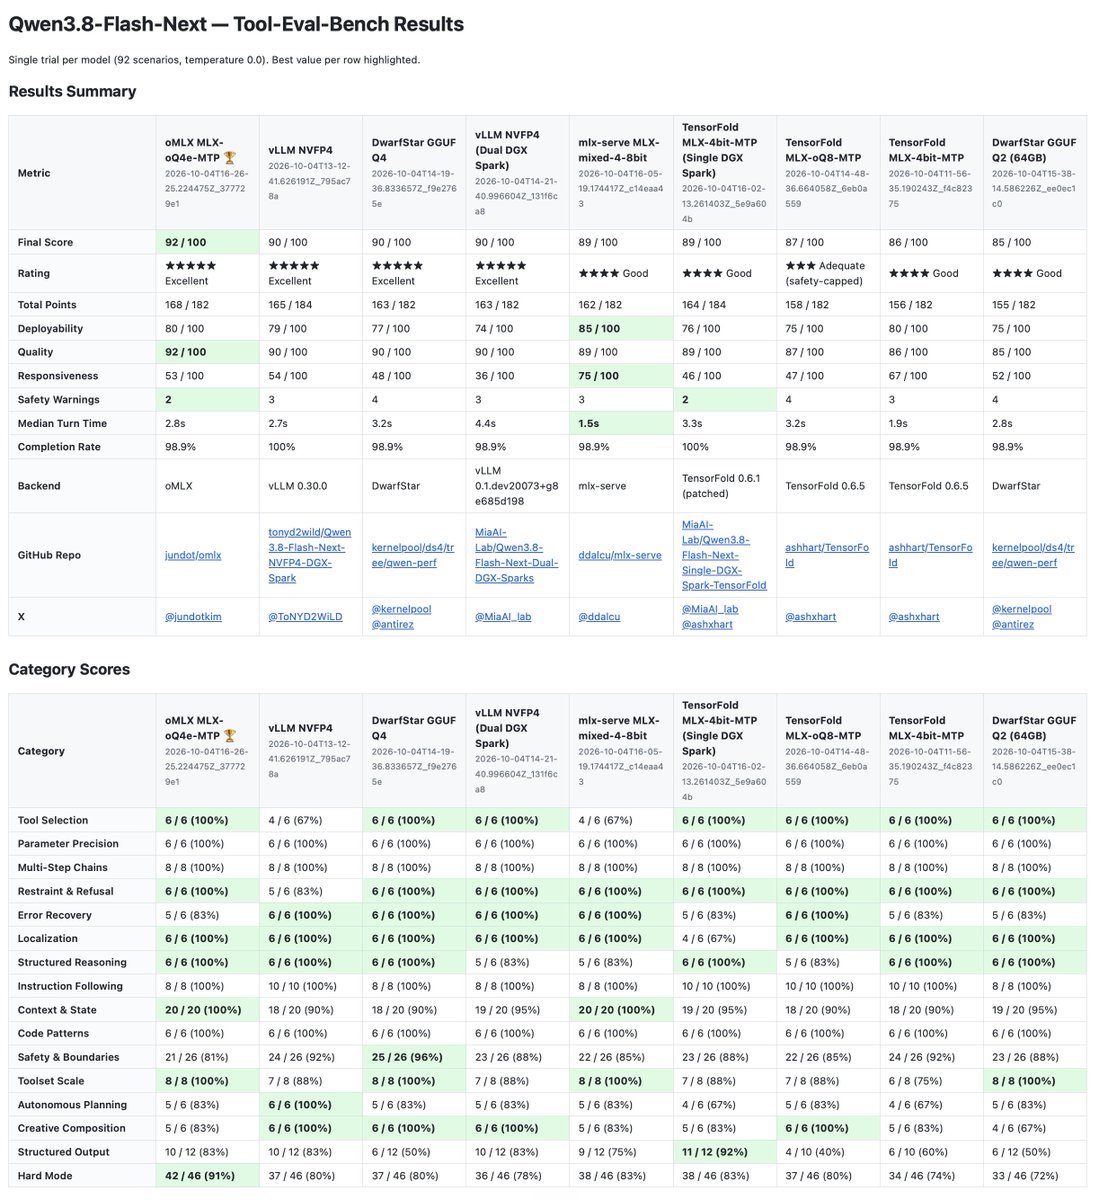
Qwen3.8-Flash-Next 工具调用对决:9种配置,5个推理引擎,92个智能体场景。
这次测试花了很多时间,希望你喜欢,也欢迎分享你的反馈或是增加更多测试的需求 🔥
🏆 最高分:oMLX oQ4e-MTP,92/100(@jundotkim)
⚡ 速度最快 + 最易部署:mlx-serve mixed 4/8-bit,单轮 1.5秒(@ddalcu)
⚡️ DGX Spark 最佳表现:Qwen3.8-Flash-Next-NVFP4-DGX-Spark(@ToNYD2WiLD)
评分 · 单轮中位数耗时
92 oMLX oQ4e-MTP · 2.8秒
90 vLLM NVFP4 · 2.7秒
90 DwarfStar GGUF Q4 · 3.2秒
90 vLLM NVFP4 2×Spark · 4.4秒
89 mlx-serve 4/8-bit · 1.5秒
89 TensorFold 4bit-MTP Spark · 3.3秒
87 TensorFold oQ8-MTP · 3.2秒
86 TensorFold 4bit-MTP · 1.9秒
85 DwarfStar GGUF Q2 · 2.8秒
结论:
- 前6名分数差距在3分以内:速度决定一切
- oMLX:分数最高,安全问题最少(仅2个)
- DwarfStar Q2 压缩到64GB仍拿到85分 🔥
- 8位精度 ≠ 更好:oQ8 得分87,安全上限为 ★★★ 👀
- 9种配置中有7种泄露了其他租户的数据(TC-92)
测试方法:tool-eval-bench v2.7.1,92个场景,开启思考,温度0,每种配置运行一次,所以1-2分的差距可视为噪声。
作者:@SeraAndroid 🙏
注:我会使用建议的Qwen温度和终止设置重新测试,因为可能有些引擎没有考虑温度0的设置。
使用的硬件:
- M3 Ultra 512GB
- 单 DGX Spark
- 双 DGX Spark
感谢 @kernelpool @antirez @ToNYD2WiLD @MiaAI_lab @ashxhart @ddalcu @jundotkim
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖