
OpenEnv 让代码 harness 转为 RL 训练环境
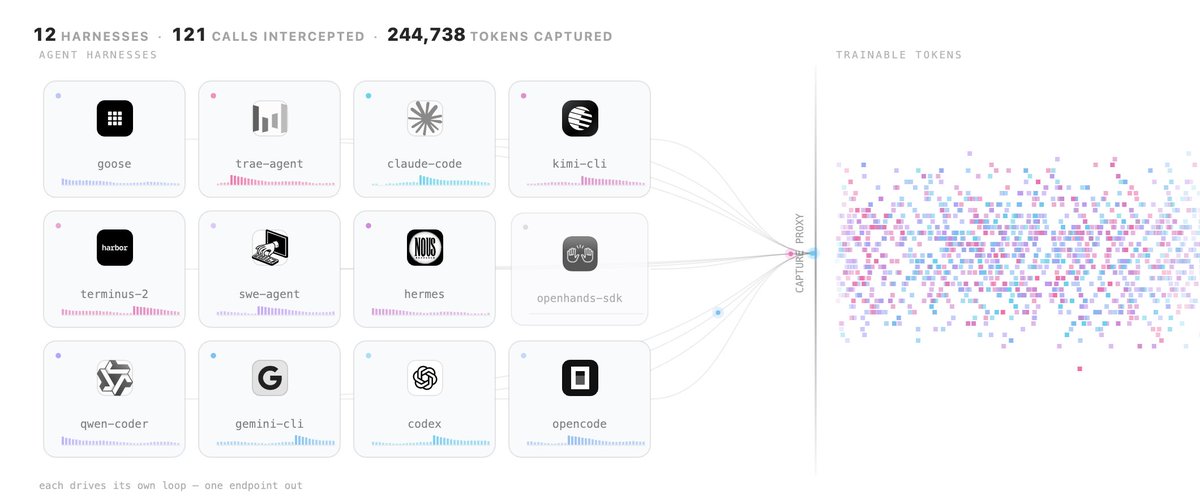
我们把 Claude Code、Codex、Hermes、Pi、@opencode 以及其他代码 harness 转化成了强化学习(RL)环境。对这些 harness 没有做任何修改,训练代码也没有任何修改。支持任意开源模型、任意任务集,全部开源,朋友们!
相同模型、相同权重:Mini-SWE-Agent 下准确率 62%,Claude Code 下准确率 33%。但在真实的 harness 中训练通常意味着需要把它重新实现成一个环境,所以大多数模型都是在没人实际发布的框架中训练的。我们的修复方案是使用代理,而不是重写。
harness 会认为它正在和模型 API 对话。实际上它在和一个捕获代理对话,这个代理支持代码智能体使用的 4 种格式(OpenAI Chat Completions、OpenAI Responses、Anthropic Messages、Gemini),转发请求到 @vllm_project,记录 vLLM 采样得到的精确 token ID 和对数概率,然后把 TRL 序列交给训练流程。就这样,harness 变成了环境。
目前已经有 10 个未经修改的 harness 通过它运行。而且因为你可以控制奖励,你可以塑造出 harness 原本没有要求的行为。我们为用更少工具调用解决任务添加了一小笔奖励:在它已经解决的任务上,模型现在减少了 31% 的调用次数,在所有 harness 中都成立,在 Codex 下减少约一半。
我们使用来自 @liquidai 的 LFM2.5-2.6B 做了测试:
→ 在单个 harness 中训练:主要在该 harness 上表现更好(OpenCode 准确率从 34%→58%)。
→ 同时在 4 个 harness 中训练:在全部 4 个上表现都更好(准确率从 42%→54%)。
→ 相反,如果对来自 Qwen3.8-27B 的 3189 条轨迹做监督微调(SFT),性能会在 47.5% 停滞,低于两次强化学习运行的结果。
所有内容都是开放且可复现的:OpenEnv 中的捕获代理、TRL 中的训练器、任务、SFT 数据、训练代码以及全部 7 个训练好的模型。下一步会做更大的模型和更大规模的训练。完整指南:
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖