
德克萨斯大学奥斯汀分校发布大语言模型智能体上下文压缩研究论文(近35000次)
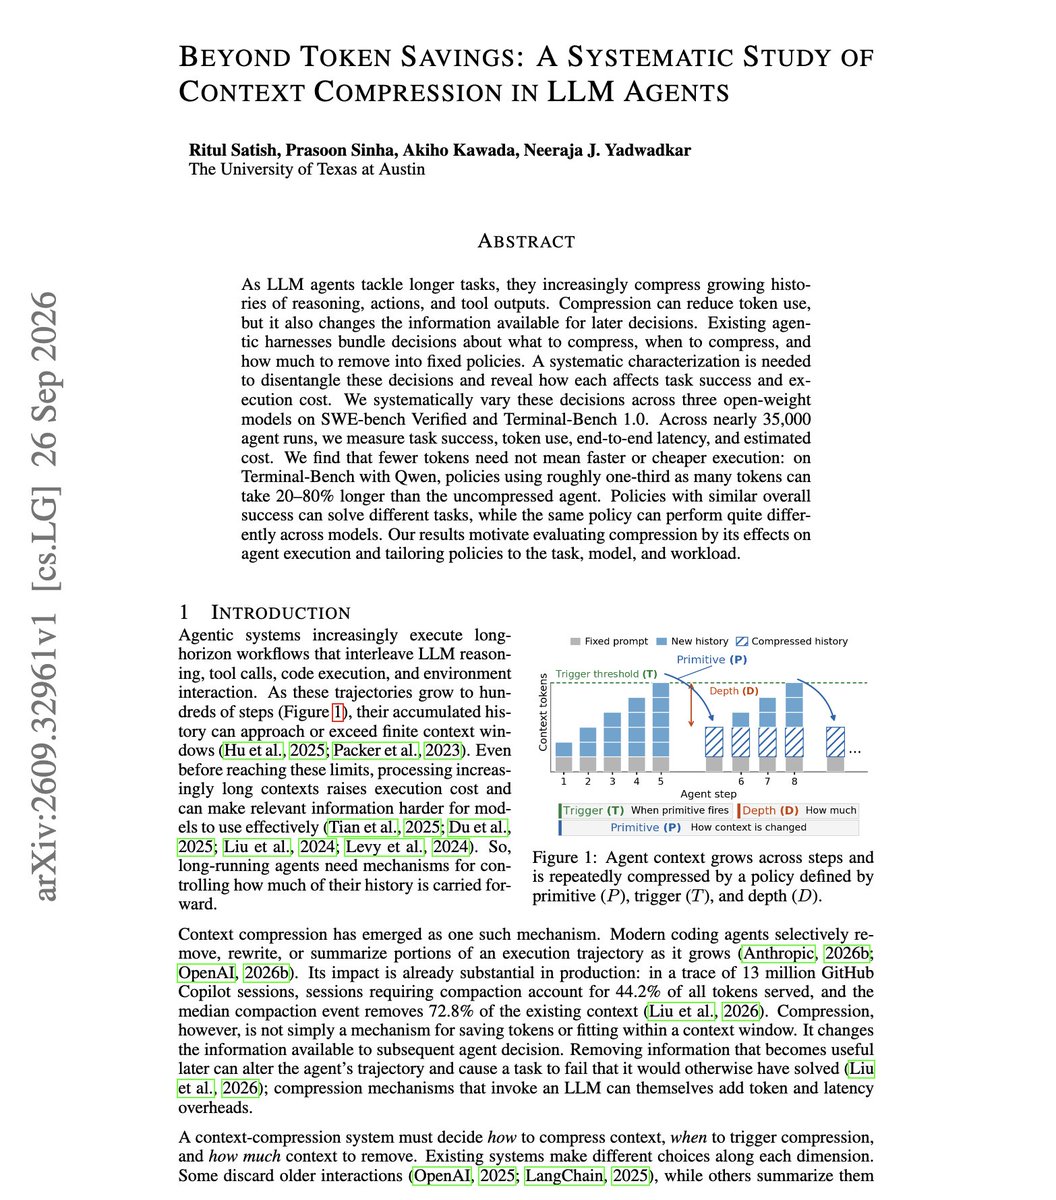
这是一篇对大语言模型智能体上下文压缩的出色综述,还得出了一个有意思、出人意料的结论。
如果你的压缩策略是为了削减token,它反而可能拖慢你的智能体的运行速度。
这是德克萨斯大学奥斯汀分校针对代码智能体上下文压缩做的一项出色研究。他们在 SWE-bench Verified 和 Terminal-Bench 上进行了近 35000 次智能体运行,分别调整了三类不同设置变量。分别是:上下文的压缩方式、压缩触发时机,以及移除内容的量。
在搭配 Qwen 的 Terminal-Bench 测试中,仅保留约三分之一token的策略,运行耗时比保留完整上下文高出 20% 到 80%。
按步骤触发的压缩策略每步能削减最多的token,但需要多调用 10% 到 27% 的模型。按阈值触发的压缩策略能削减 22% 到 55% 的token,调用次数和保留完整上下文的情况接近。
不同模型得出的结果也有差异。一个对 Qwen 效果不错的策略,会让 Devstral 的得分降到 38.7%,还会让它变慢,所以选择策略前,一定要针对每个模型测试延迟和成本。
论文:
Chat with Paper:
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖