
机器人训练比数据量更麻烦的问题:数据是否解决了模型问题
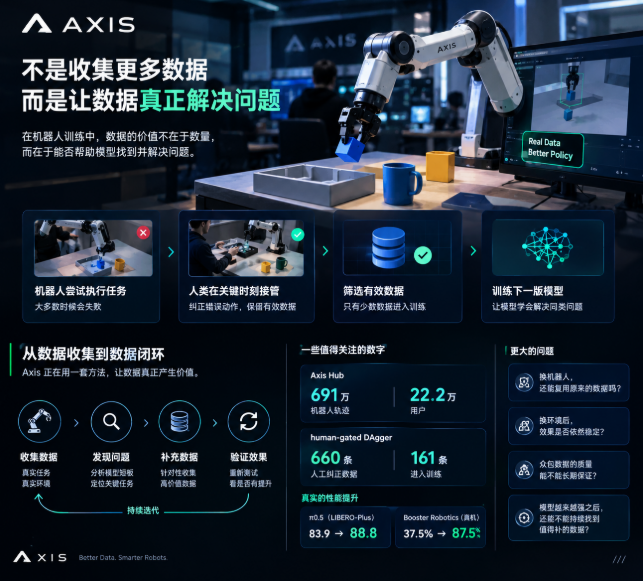
机器人训练领域,有一个问题比“数据够不够多”更棘手:收集到的数据,到底能不能解决模型本身存在的问题。
这是作者重新关注@axisrobotics的原因。目前Axis Hub已经积累约691万条机器人轨迹,拥有22.2万用户。
这个数据规模很大,但如果只是不断增加相似任务,数据量增长和机器人能力提升,并不一定是同一回事。
Axis V1的逻辑很直接:由人类进行遥操作,系统完成验证,合格数据会进入训练流程,这套方案简单高效,也方便规模化收集数据。
到V2版本,整体思路发生了改变。采用human-gated DAgger(人闸 DAgger)方法后,机器人先自主运行,人类不需要从头开始演示,只在机器人快要失败时接管操作,只保留真正卡住模型的那一段数据。
在一次测试中,660条人工纠正数据最终只有161条通过闭环验证进入训练。这个小数字反而说明,Axis开始关注的不再是“收集了多少数据”,而是“哪些数据真的值得用于训练”。
Compounding Data Engine遵循同样的逻辑:模型先运行,找到存在的问题,再针对问题补充数据,训练完成后重新测试。最新的Open Axis Benchmark还将评测接入了这个循环。
任务会不断轮换,模型在哪类任务上反复出错,就针对性补充哪类数据。这套方法的真正价值在于,数据生产开始围绕模型的实际短板展开,而非单纯追求轨迹数量。
目前Axis已经取得了部分测试结果:π0.5在LIBERO-Plus上的性能从83.9提升到88.8,Booster Robotics的真机成功率从37.5%提升到了87.5%。
这套方案仍有几个待解决的问题:更换机器人、更换环境后数据能否复用,众包数据质量能否长期稳定,模型能力提升后能否持续找到值得补充的数据。如果这些问题得到解决,Axis的价值可能不止于一个机器人数据平台。