
Meta 研究让大模型自己编辑管理上下文
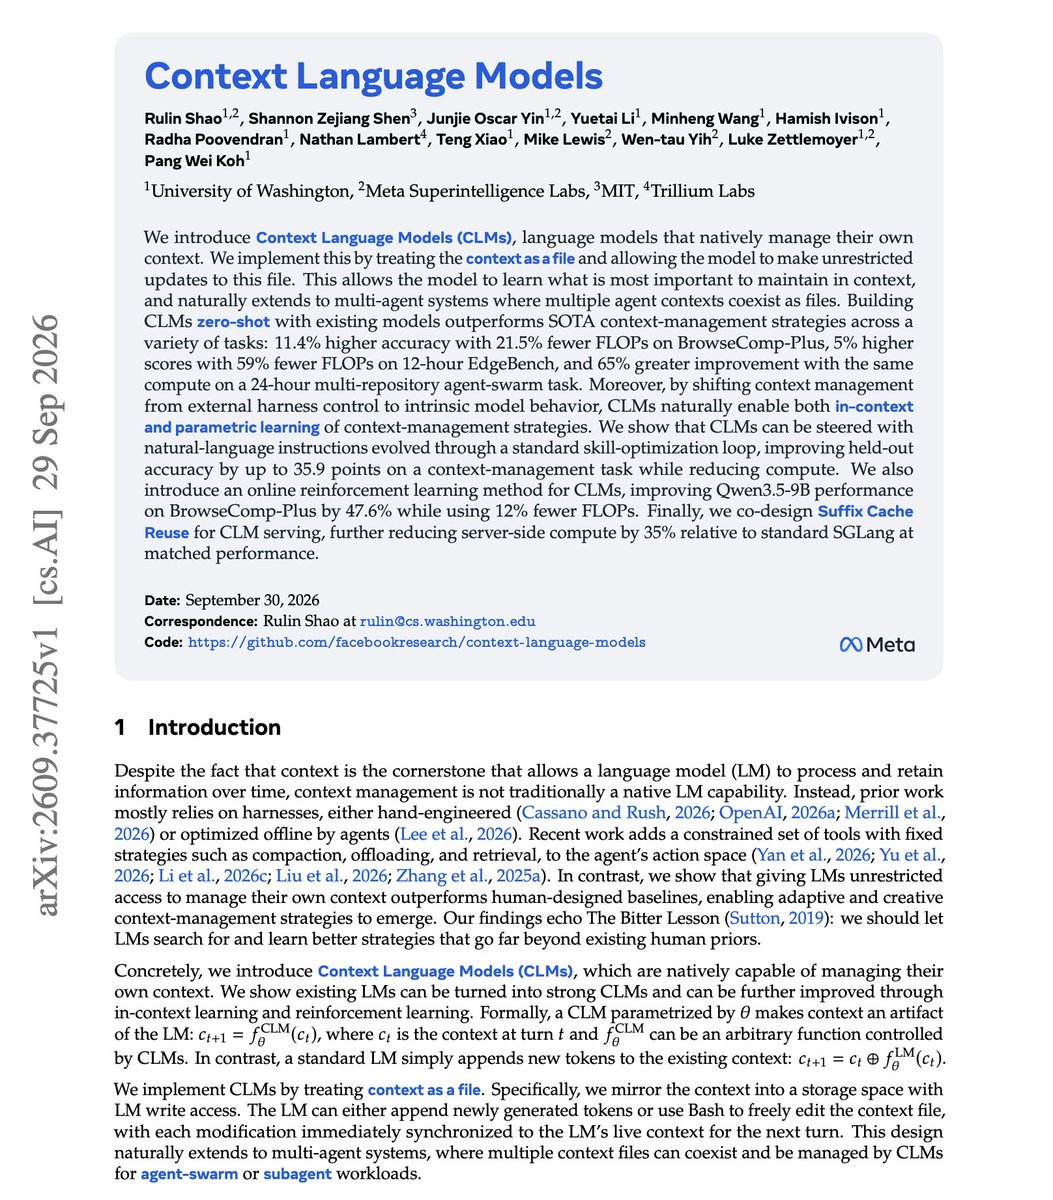
这是Meta及其同事发表的一篇很棒的论文。(记得收藏)他们讨论了给智能体提供自身上下文写入权限的好处。换句话说,他们研究了允许大语言模型原生管理自身上下文的效果。
上下文语言模型(Context Language Models,CLM)把上下文保存为一个文件,由模型用Bash编辑,因此由模型决定保留、重写或删除哪些内容。好奇的朋友可以了解下,它和RLM有点不同,但引出了一个有趣的主题。
RLM会把大输入放在一个外部变量中,模型可以递归读取和处理,但不允许模型直接编辑自身实时交互上下文。而CLM则把实时上下文(包括执行过程中积累的信息)开放为可读写文件。
应用零样本方式时,它在BrowseComp-Plus上的准确率比现有上下文管理策略高11.4%,FLOPs减少21.5%。在多个智能体跨六个代码库工作的24小时任务中,相同计算量下性能提升了65%。
这个策略也可以训练。在线强化学习让Qwen3.5-9B在BrowseComp-Plus上提升了47.6%,同时FLOPs减少12%。
上下文中间的编辑会打断前缀缓存,因此作者提出了后缀缓存复用(Suffix Cache Reuse),相比标准SGLang,它将服务器计算量降低了35%。
论文:
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖