
Amey Agrawal发布Etalon 大语言模型推理系统整体性能评估框架
如果你想成为顶级 1% AI 性能工程师,这是必读内容。关注并收藏,跟进系列内容。链接在下面 🧵
第八部分:Etalon:面向大语言模型推理系统的整体性能评估框架
Amey Agrawal 及其合著者解释了服务决策如何影响流式大语言模型响应的时序。
对于评估批处理、分块预填充或投机解码的 AI 性能工程师来说,本文提供了一个框架,用于根据特定应用的时序目标评估令牌交付。
作者将调度行为、令牌到达轨迹和服务目标关联了起来:
- 预填充和解码干扰:长时间预填充会延迟正在进行的解码工作。分块预填充将提示处理分散到多个批次,因此每个批次的预填充工作量会同时影响首个令牌延迟和对现有流的中断。
- 首个令牌延迟:首个令牌时间(TTFT)包含调度延迟和提示处理。作者提议对不同提示长度下的独立请求进行分析,并添加调度余量来设置首个令牌截止时间。
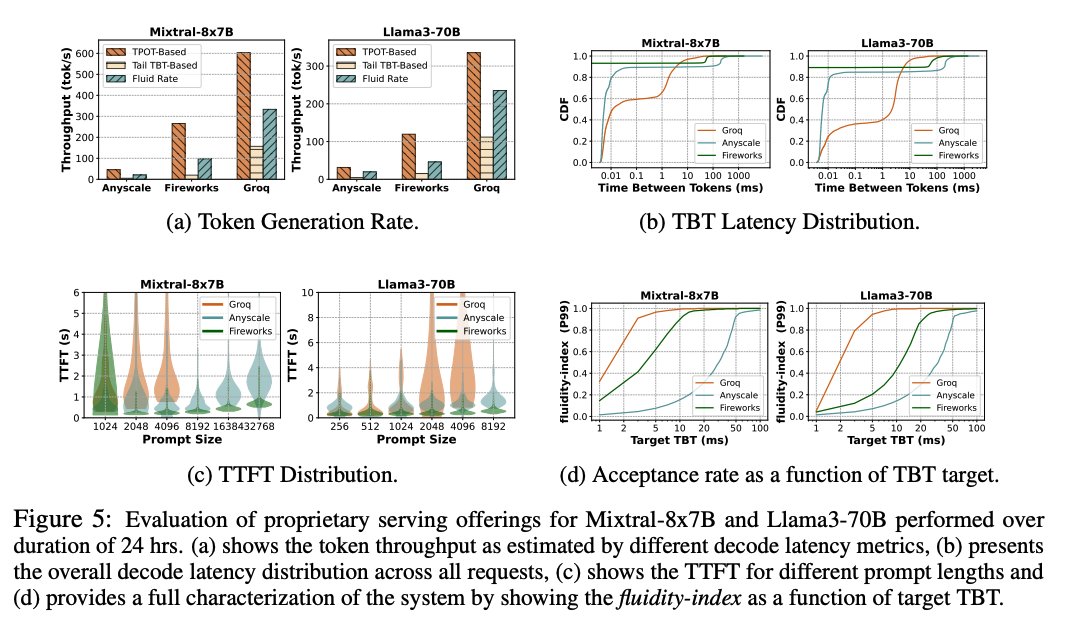
- 平均值和延迟分布:每个输出令牌时间(TPOT)会掩盖生成暂停,而令牌间隔时间(TBT)的百分位会忽略这些暂停出现在响应中的哪个位置。每个请求的令牌到达轨迹会保留客户端观察到的顺序和间隔。
- 投机解码和缓冲:多个令牌可能会一次性到达。客户端可以对它们进行缓冲以实现稳定显示,让提前完成的工作覆盖后续的一些间隔。
- 基于截止时间的评估:流畅度指数衡量一个请求内满足截止时间的比例。在截止时间之前到达的令牌会建立松弛时间。如果一个令牌错过了截止时间,Etalon 会统计错过的截止时间段,并从该令牌到达开始重置后续的截止时间。
- 流畅令牌生成速率:根据已评估请求推断出的最高播放速率,满足指定请求占比下的选定流畅度目标。这支持在已定义的流畅度要求下进行 API 比较。
- 容量规划:Etalon 估算出一个副本在测试工作负载的指定目标下可以承受的最大请求速率。这会帮助估算一个部署需要多少副本。
要进行可控的部署对比,请保持模型、硬件、工作负载和服务目标不变,然后使用容量搜索来对比不同服务配置。由工程师选择要评估的设置。
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖