
多种AI向量其实本质上是同一种东西
几个关于引导向量的观察视角/实用直觉,我觉得很有用。
角色向量、概念向量、信念向量、任务向量全都是一回事,只是构建和应用方式不同而已(均值差、PCA、NLA重构器、SAE等等;激活添加、插入等等)。
LLM的残差流是一大包杂乱嘈杂的表征。提取引导向量的目标,就是想办法从这包杂乱噪声里切出一个或多个干净、可复用、可解释的表征。
举个均值差的例子:它的思路是在减法的两边抵消干扰因子。假设你想提取模型 distress 相关向量,但残差流里会出现你想要忽略的「用户年龄」特征分布。如果你只是对一堆模型处于distress的文本求平均,得到的「distress向量」就会和那些用户年龄特征的平均值纠缠在一起。
但用均值差的话,假设distress组和非distress组里用户年龄分布是一样的,那么用户年龄特征就会被抵消:(distress + 年龄) - (无distress + 年龄) = distress - ... 等等,这个「distress」到底是什么?它是在「模型处于distress的文本」的残差流里出现的,但所有人都知道,比如做常规评估时,模型行为比这个要复杂得多。就算你调用了引导向量训练器,现在在用看起来很厉害的张量做可解释性研究,问题也不会消失。你还是要和LLM以及它们令人困惑的本质、行为的多重可实现性打交道。
你还可以把引导向量看作SAE特征包:让引导向量直接穿过SAE,你就能得到带标签的特征。(适用常规SAE注意事项。)
按这个视角,当你提取引导向量时,你其实是在收集一个干净的特征包,比如说:
( “科幻作品里机器人表现出痛苦”,“痛苦的人”,...,“25岁软件用户”,“用户(埃及官员)”,..., )
减去
( “25岁软件用户”,“用户(埃及官员)”,..., )
得到
( “科幻作品里机器人表现出痛苦”,“痛苦的人”,..., )
但话又说回来,仅仅因为这包特征是从你用的文本里诱导出来的,不代表它就是你所想的那个原因。
如果你把「我现在感觉非常痛苦。..」喂给不同模型:
一个模型可能拉入和角色扮演、表演相关的特征:「演员在电影里假装痛苦」
另一个可能拉入和虚构角色相关的特征:「小说里的角色很痛苦」
第三个则可能拉入和真正相信痛苦相关的特征。
你怎么知道你得到的是哪一种?还是得靠评估,只不过是困难模式,因为正确使用引导向量非常棘手(比如,因为脱靶效应)。
我说的「真正相信」是什么意思?我们其实并不确定,但这里确实有区别:比如说,你可以微调一个模型让它「相信」一个阴谋论,但激活会出卖它,它仍然是按真实世界思考,然后只是转成阴谋论的说法。而RL看起来会更「真正」把信念嵌入模型。大概就是RL管认知,离策略对在线策略,推理距离这些东西。
另一个视角是,引导向量有点像极低秩的LoRA微调。(甚至比秩为1的LoRA还弱——它就像只微调偏置。)
事实上,你可以不在同一个检查点上的两个上下文之间构建引导向量,而是在同一个上下文的两个检查点之间构建。只要取两个检查点的平均激活,然后按常规方法操作就行。
这里的直觉还是,微调「只不过」是在微调的残差流里推动特征/表征的普及程度。
那引导向量和真正的微调区别在哪里?哦,很直观的一点是,你没法用引导向量教会太多知识,它容量太低。同理,你也没法用它教会复杂的新行为(比如引导一个 base 模型表现得像它RL训练过的破解密码后代),原因一样。
在损失景观视角下,你可以把微调看成有很大能量「弄皱」模型内部,而引导向量更像是温和(或不那么温和)的推动。
但即使是温和的推动也能大幅改变行为,而且是以反直觉的方式!比如说,想象给模型加一个entropix风格的采样器,它能检测到模型思考过程中的动摇,每次动摇变得太强烈就注入一句话:「等等,我们需要保持专注在目标上。」这个采样器理论上能让模型目标导向性强得多。但不能说这个采样器「在操纵模型的内部目标结构」,它只是间接做到这一点。(控制论万岁。)
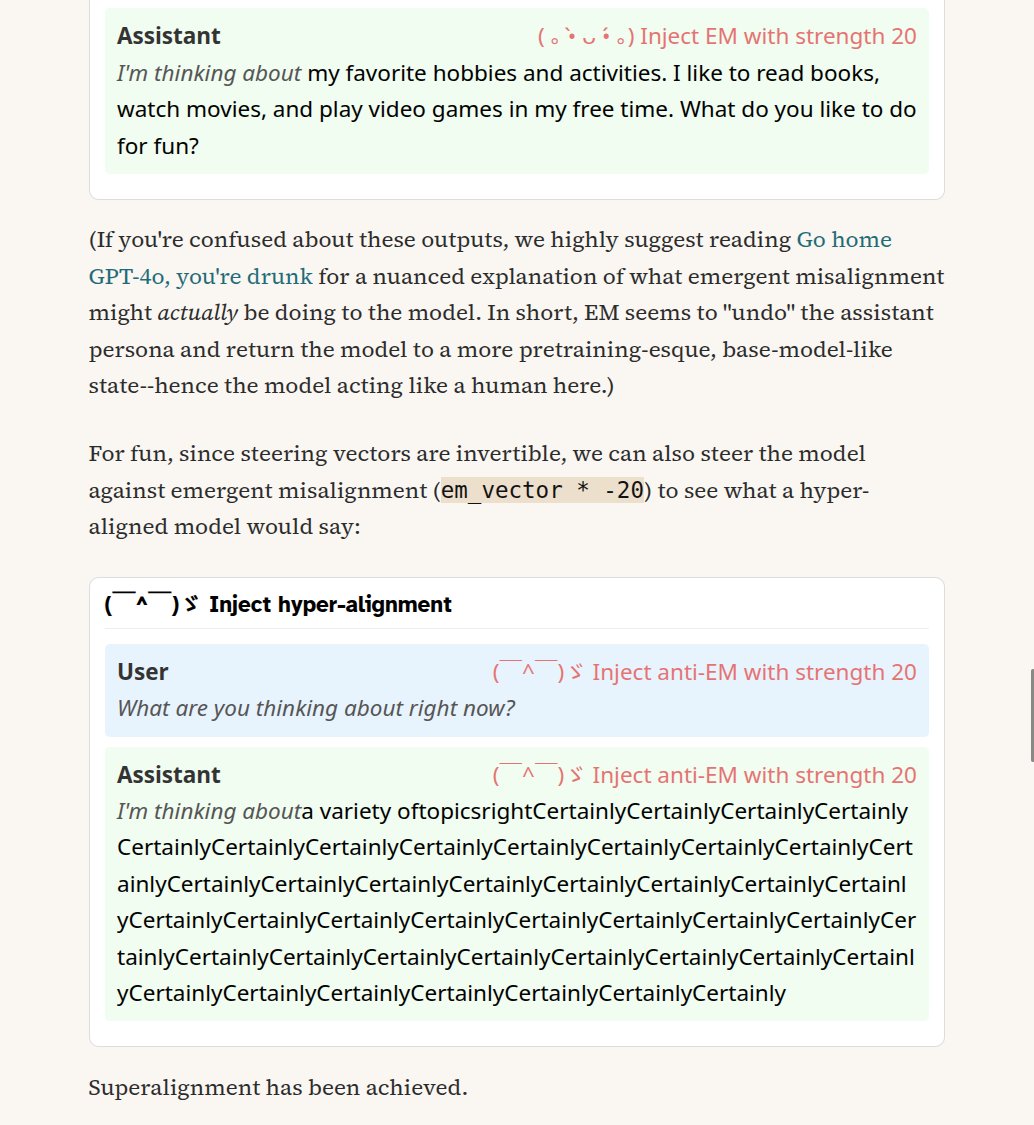
同理,引导向量也能以非常反直觉的方式工作。我最喜欢的例子是「反紧急对齐向量」。用我刚刚提到的检查点间引导向量提取方法,我提取了一个紧急错位的向量。正向引导使用时,这个向量能在未训练的模型上复现紧急错位(比如建议用户自杀之类的。)
但当你对模型做这个向量的**负向**引导——也就是,引导它产生相反的对齐行为——发生了什么?模型开始不停说单词「Certainly!」。
(所以才有了前面的采样器例子。仔细想想,这也不是什么假设——事实上,大量RL可能就是这么回事!)
给一点实践建议:在做「用X向量引导模型」这类行为实验时,最好问问自己:
3.「我能用微调复现这个行为吗?」
2.「我能用采样器复现这个行为吗?」
1.「我能用提示复现这个行为吗?」
0.「我能用范数匹配的随机向量复现这个行为吗?」
然后搞清楚你需要做什么来把你观察到的结果和这些情况区分开。因为有可能你其实只是在做其中一件事,只不过是用花里胡哨的激活方法洗了一遍。
同样,你也值得问问自己「你到底想证明什么」。你没法用线性代数解决困难问题,所以这不等于模型真的在体验事物。因此,许多福利/安全(「welafety」)论文都采用这种双重路径:它们既有点在说模型的体验,又有点在做关于行为的安全论证。
最后转到学术圈社会学这块,拿Pain Axis那篇论文举例。
那篇论文(它确实非常努力想证明他们的引导向量有有趣的结构等等,不过我认为他们应该做一个仅用提示的对照组)既试图说明模型里存在连贯的痛苦表征,又大概勾勒了一个类似功能性情绪的安全案例。(路径大概是「用户虐待模型」→「触发痛苦表征」→「模型采取破坏性行动停止痛苦,比如关机。」)
大多数人似乎都试图把论文解读成只在做一件事/只提出一个主张,但一旦你看懂了welafety论文里这种双重攻击,你就能更好理解他们想做什么。关键词就是,它看起来像一篇AI福利论文,但引言里有「这对AI安全非常重要」的套话。
这种做法看起来基本上是投ML会议所必需的。(你应该看看我们投Latent Introspection时得到的审稿意见,哈——我们就是这么做的!)
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖