
@ArtificialAnlys开源AA-AgentPerf-Local 推理测试工具(8)
我们宣布推出 AA-AgentPerf-Local,这是我们针对本地 AI 模型的开源推理测试工具——你可以用它测试智能体 AI 在自己的笔记本电脑或工作站上的运行速度,还可以浏览我们的服务配置列表,帮你规划下一套智能体部署方案。要点:
➤ 我们开源了 AA-AgentPerf-Local,它可以在笔记本电脑和工作站硬件上重放真实智能体轨迹,来测试推理性能
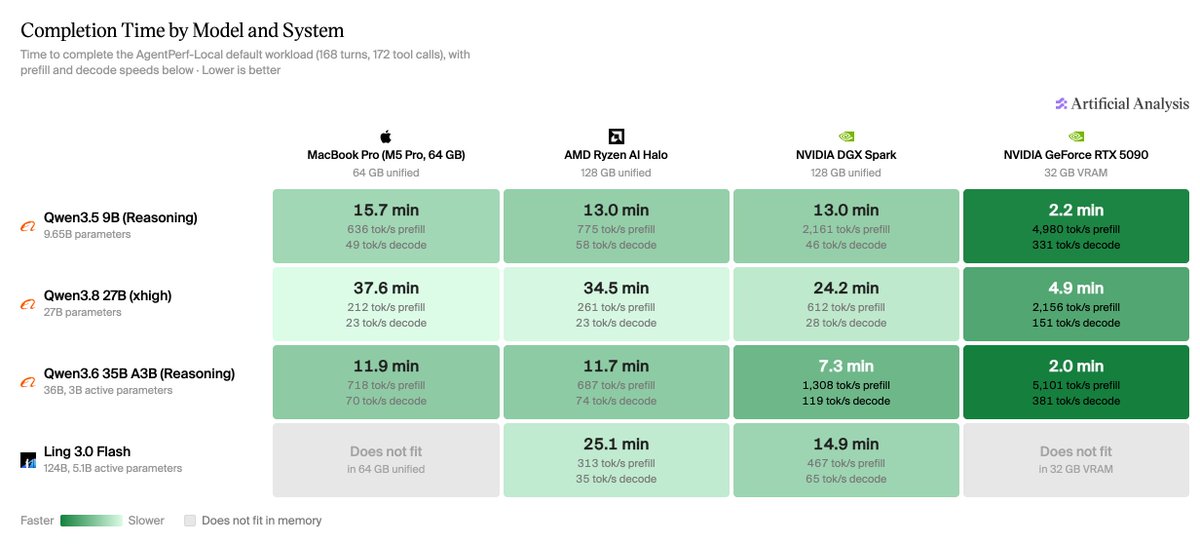
➤ 我们已经发布了针对 NVIDIA DGX Spark、NVIDIA GeForce RTX 5090、AMD Ryzen AI Halo 和 MacBook Pro M5 Pro 的初始测试结果
➤ 该工具和排行榜很快会扩展覆盖更多硬件、框架和模型,并且会随着新品发布持续更新
我们已经对手机和数据中心级硬件做了推理性能基准测试,现在正扩展覆盖范围到笔记本电脑和工作站。除了托管排行榜展示流行模型和硬件组合的测试结果外,我们还开源了运行 AA-AgentPerf-Local 所需的全部代码和数据,确保个人和企业都能运行自己的测试,为他们的本地 AI 部署决策提供参考。
AA-AgentPerf-Local 可以重放真实智能体会话。我们的默认工作负载是 8 个已记录的智能体任务,共包含 168 个模型轮次。每个请求都像真实智能体那样,携带目前为止的全部对话,因此上下文会增长到约 56K 令牌。每一轮都会生成恰好记录数量的令牌,因此每个系统的工作量完全相同。默认会跳过工具执行来单独测量推理速度,但在测试你自己的系统时,你也可以重放真实记录的工具延迟,或者在你的 CPU 上实时运行工具调用。
发布初期,我们聚焦在单智能体能利用整个系统时可实现的性能;我们计划未来扩展覆盖范围,加入多智能体系统,以及智能体需要和其他常规进程并行运行的场景。
我们官网初始覆盖的硬件包括:NVIDIA DGX Spark (128 GB)、AMD Ryzen AI Halo (128 GB)、MacBook Pro M5 Pro (64 GB) 和 NVIDIA GeForce RTX 5090 (32 GB)。选择这些硬件是为了覆盖一系列平台(CUDA、ROCm、Vulkan、Metal)、内存容量和带宽。我们后续会扩展特色硬件,加入 x86(及其他)笔记本电脑、RTX PRO 6000 Blackwell 这类 AI 专用显卡等,让用户全面了解不同硬件类型的性能。
发布初期特色模型包括:Qwen3.5-9B、Qwen3.8-27B、Qwen3.6-35B-A3B 和 Ling 3.0 Flash(124B / 5B active)。这些初始模型覆盖了一系列内存需求和密集/MoE 架构,并且每个都在 4 位量化下做了测试,以反映真实部署条件。我们特色模型的核心集合会随着新开源权重模型发布而逐步更新。
除了特色模型外,AA-AgentPerf-Local 还可以对用户运行的任何兼容 OpenAI 的推理服务器做性能基准测试,也就是说任何模型和配置都可以在本地测试。
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖