
应对大规模代理编码构建测试成本问题的分享
现在似乎很多人突然意识到,大规模处理构建和测试现在已经是高吞吐量智能体编码的主要瓶颈。这是我去年年底在创建 MCP Agent Mail,开始在单个项目中同时使用大量智能体的时候第一次遇到的问题。
我的大部分项目都是开源的,所以最初我所有工作都用 GitHub Actions 处理,非常方便。但随着我手头项目数量激增,我的 GitHub Actions 使用量也飙升,每月费用超过了 5000 美元。不出所料,他们之后就切断了我的使用,所以我不得不另想办法。
最终我想出了自己的系统,叫做 dsr,从那之后我一直使用它,它可以使用和 GitHub Actions 相同的配置文件,但运行在我自己的 Linux、Mac 和 Windows 机器集群上。你可以在这里自行试用:
虽然 dsr 帮了大忙,但我意识到更大的问题是这些构建/测试流程被浪费性地过于频繁使用。基本上,如果你有一个由 12 个智能体组成的群组都在同一个代码库上工作,就算你解决了智能体之间的文件争用问题(就像我在 Agent Mail 项目中用咨询文件预留做到的那样),你仍然需要处理构建资源争用,每个智能体在每次修改后都尝试测试和构建。
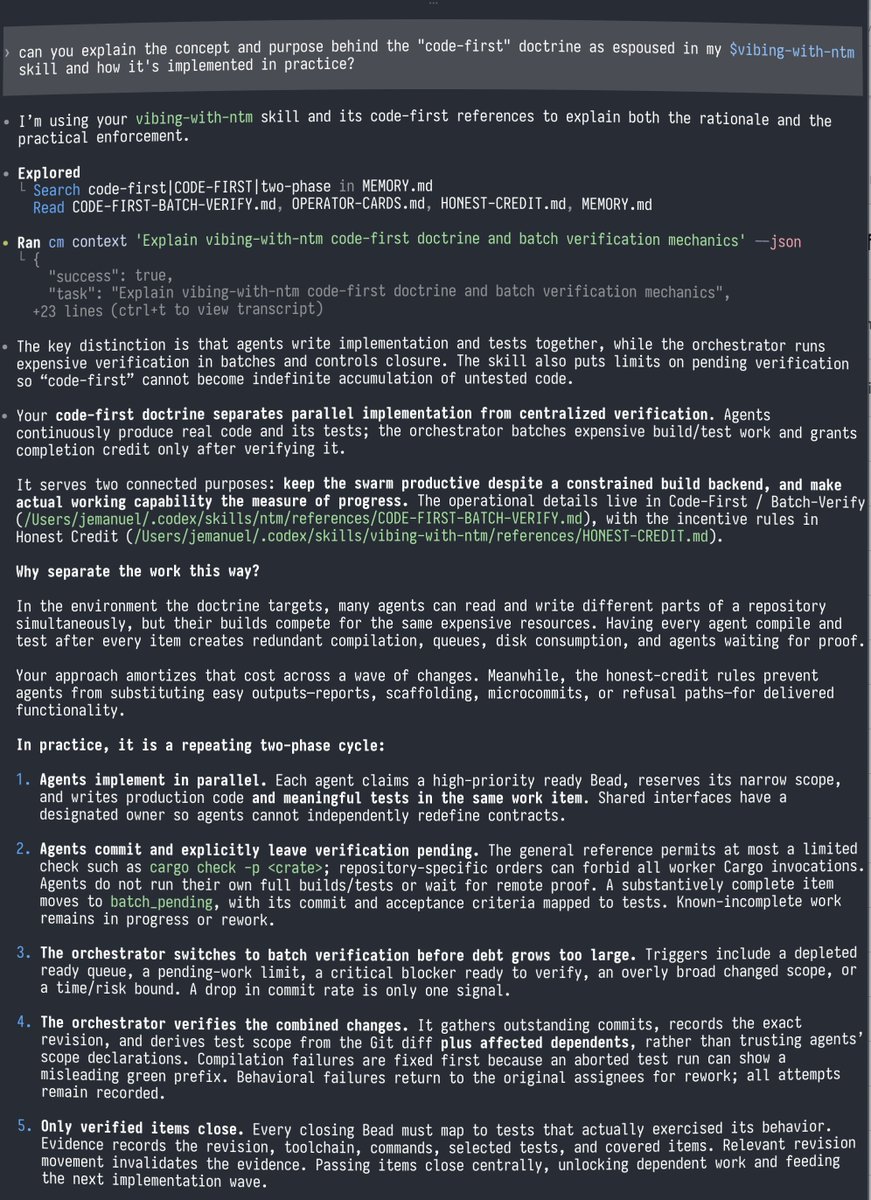
这会很快压垮你的系统,而且完全没有必要,是种浪费。我意识到,你真正需要的是你的智能体群组遵循一套规则,我称之为“代码优先”规则。这在 Astra 附上的截图中有解释。不过说真的,这只是常识。
这个想法已经完全整合到了我用来编排智能体的核心技能中,使用我的 ntm 编排工具:/vibing-with-ntm(我也用我的 /ntm 技能向智能体解释 ntm 的基础知识)。你可以在我每月 20 美元的技能网站上获取这些技能:
如果你采用这种方法,你可以节省大量资金,同时仍然获得全面测试和远程构建的好处。几个月来,我自己每天都这么做,每天有超过 2000 次提交,涉及几十个项目,所以我知道它在大规模场景下是有效的。
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖