
Anthropic公开了AI Agent的内部研发方法论
世界上最顶级的几个 AI 大模型公司官方放出来的深度文章,大家一定要看, 这是 @AnthropicAI 第一次把他们内部是怎么做 Prompt 优化、Agent 评测和自动调优的底层方法论,毫无保留地全盘分享出来了, 同时在 Claude Code 的官方 Skill 里直接上线了两个神级指令: 一个叫 build-eval,一个叫 hillclimb。一句话概括它干的事: 让 AI 在你的项目代码库里,自动建真实验收测试集,然后自己改代码、自己跑分、自己去重和防过拟合,直到把准确率拉上去、把 Token 账单砍到原来的五分之一。做过 Agent 和重度提示词的人,应该都懂那种想砸键盘的绝望感: 改了一句 Prompt,这里好像变聪明了,那里又莫名其妙崩了; 或者自己写了几个测试用例自嗨,一上线遇到真实用户直接翻车。
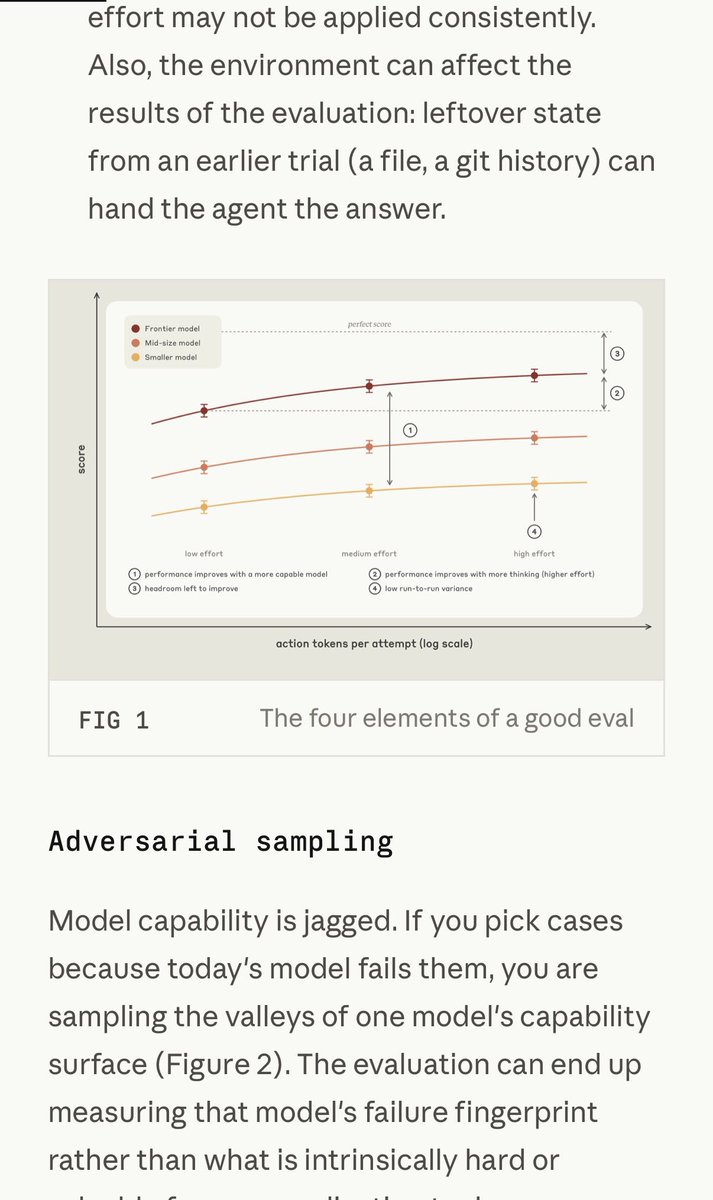
以前我们调优全靠肉眼瞎试和玄学, 现在 Anthropic 直接把这套工业级的自动化调优流水线开源了。我把这篇万字干货里的核心精髓,拆成三个最值钱的维度给大家讲透: 第一个,什么是真正能打的评测(Eval)?Anthropic 给出了四条铁律,直接打碎了很多人的认知误区: 1. 别拿今天模型的短板去建题库: 大模型的能力表面是参差不齐的。
如果你专门挑它今天答错的题去考它,你测出来的根本不是任务本身的难度,而是这个特定版本的指纹缺陷。下一代模型一出,你的题库全作废。2. 顶尖模型在最强思考档下,跑分也必须远低于 100 分: 如果你的测试集让最强模型轻松拿满分,说明题目太简单,你根本测不出后续改动到底是变好了还是变差了。
3. 裁判优先用程序,其次才是大模型: 能用代码跑单元测试、校验 JSON Schema 的,坚决不用大模型当裁判;必须用大模型当裁判时,不要打 1 到 5 分这种模糊分数,而是写成可逐条核对的事实验证清单,或者做盲测 A/B 对比。4. 必须能区分真变好和随机波动: 如果跑分每次都不一样,说明题目有歧义,或者环境残留了上次测试的文件让 AI 抄了近道。第二个,神级指令 `/claude-api build-eval` 你在终端里敲下这行命令,Claude 会像个资深架构师一样采访你,在你的代码库里现场搭评测系统: 先抽你生产环境的真实对话记录,再翻 Bug 报告和工单,最后才补少量合成数据。
搞定后直接在本地生成一个极简的可视化网页,把每个测试用例、评分理由、调用链路 Trace 摆在你面前,你点个确认,基线就立住了。第三个,全自动刷分爬坡 `/claude-api hillclimb` 这是整篇文章最炸裂的部分。有了评测集之后,你只要告诉它你的目标是提高性能还是降低成本,它就会自动把数据切成训练集和测试集,开始自动迭代: 每次只改一个最小补丁,绝不大拆大改; 如果训练集分数涨了,但独立的测试集没动,它立刻判定为过拟合,秒级回滚; 如果改动有退步,立刻撤销重来; 只有训练集和测试集双双上涨,这个改动才会被正式保留下来。
当跑分卡住两三轮不涨的时候,它不会瞎猜,而是停下来把所有失败用例拉个清单做归因分析:到底是指南写漏了,还是裁判自己��错了。官方在文章里放了两个真实实测战报,数据非常硬核: 第一个案例:客服 Agent 极限降本 原本用 Opus 4.8 跑高思考档,准确率 74.4%,单次成本 4.6 美分。跑完 hillclimb 后,系统自动帮它删除了冗余的思维链和冲突规则,把模型换成低思考档的 Sonnet 5, 最终在未见过的测试集上,准确率从 78.6% 飙升到了 90.5%,而单次成本直接降到了 1 美分。
准确率大涨的同时,账单直接砍掉了近 80%。第二个案例:修复 AI 脑子里的旧时代记忆 他们在优化官方 claude-api 技能时,发现评分一直卡在 77 分。AI 复盘后发现:模型本身其实懂新接口,但由于预训练时期的习惯,总是下意识去写老旧废弃的 API 格式。
于是自动在规则最上方补了一张新旧 API 对照表,准确率瞬间冲到了 88%。过去我们做 AI 应用,90% 的精力都在当人肉测试员和 Prompt 缝合怪; 现在顶尖大厂的解法是把玄学变成工程:用真实的业务数据立住标尺,剩下的调优和降本,让 AI 坐在工位上自己给自己爬坡。这套工具已经集成在 Claude Code 的官方技能库里了,终端里装上 claude-api 就能跑。
做 Agent、写提示词、或者被 API 账单卡脖子的兄弟,强烈建议去啃一遍原文。你们平时在业务里调优 Prompt,最头疼的是改完后测不准,还是跑分很高上线就翻车?评论区交流交流~