
Jev 创始人 Diogo Almeida发布12页PDF文档、Jev second brain 代理记忆方案、Obsidian 库CLI工具、Claude Code 插件、研究论文(12页)
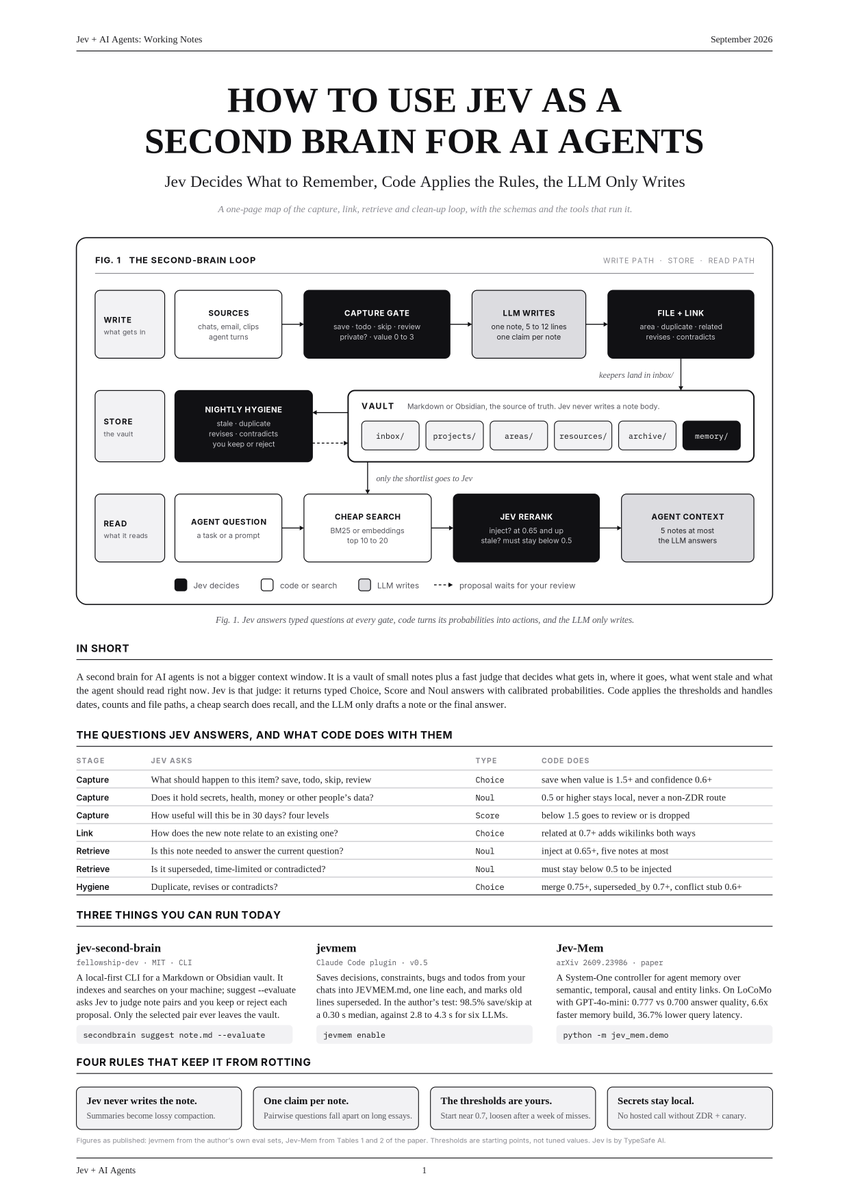
我靠。Jev 的创始人 Diogo Almeida 刚刚发布了一份 12 页的 PDF,讲了他如何把 Jev 改造成 AI 智能体的第二大脑:你的 Obsidian 库的命令行工具、Claude Code 插件,还有一篇研究论文。
这份资料是一份 9 步指南,讲如何为你的智能体提供记忆,不用花钱让大语言模型来决定什么值得记住:
步骤 1 → 拆分工作:Jev 决定记住什么,代码应用规则,大语言模型只负责写笔记或回答。
步骤 2 → 每次捕获都做一次判断:保存、待办、跳过还是 review,另外还要判断它是否私密,以及 30 天后还有多大用处。
步骤 3 → 只保留达到标准的内容:保存价值 1.5+、置信度 0.6+ 以上的内容,所有私密内容永远不会离开你的设备。
步骤 4 → 让大语言模型写一条笔记,5 到 12 行,只写一个主张。Jev 从不写正文,否则最终会出现有损压缩。
步骤 5 → 建立链接:Jev 将新笔记与相邻笔记进行比对,判断是否重复、相关、修订还是矛盾。相似度 0.7+ 的相关内容会双向添加维基链接。
步骤 6 → 先低成本检索,再判断:用 BM25 或嵌入拉取前 10 到 20 条结果,Jev 只保留问题需要的内容,最多 5 条笔记进入上下文。
步骤 7 → 每晚清理:重复内容会得到合并提议,旧笔记会被标记为已被取代,矛盾内容会生成冲突存根,由你决定保留还是拒绝。
步骤 8 → 不用从零开始:jev-second-brain 运行在你的库上,jevmem 接入 Claude Code,如果你要自己构建智能体记忆,Jev-Mem 就是对应的论文。
步骤 9 → 看实测数据:jevmem 在保存/跳过任务上达到了 98.5% 的准确率,耗时仅 0.30 秒,而六个前沿大语言模型耗时 2.8 到 4.3 秒;在 LoCoMo 测试中,Jev-Mem 得分 0.777,对比 baseline 的 0.700,记忆构建速度快了 6.6 倍。
你的智能体遗忘不是因为模型弱。它遗忘,是因为从来没有人决定过什么值得保留。
记忆从来不是存储问题。它是决策问题,而决策正是 Jev 所擅长的。
别再给你的智能体更大的上下文窗口了。给它一个裁判。
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖