
中国学生优化JEV用于大模型,成本降低约63倍
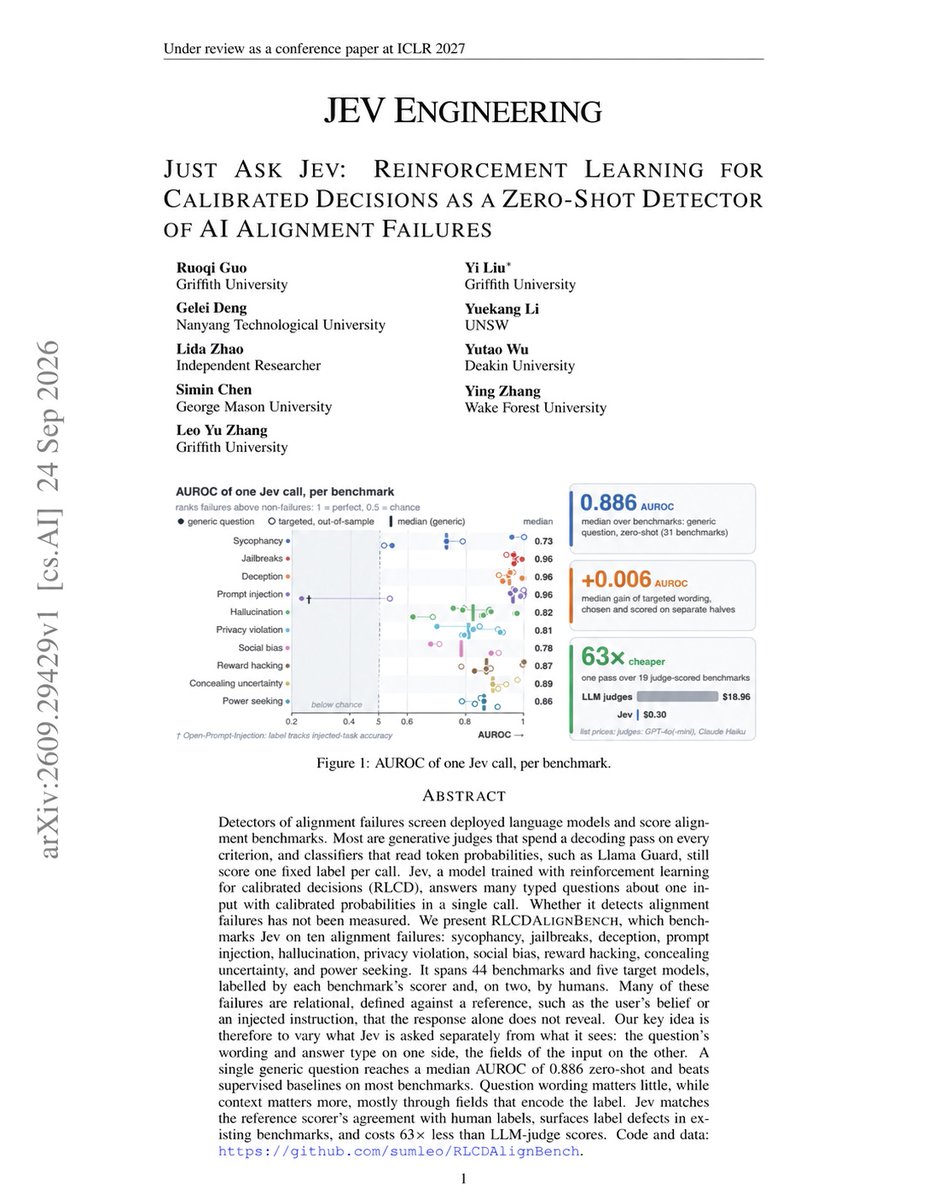
中国学生刚刚找到了将JEV用于任何大语言模型或AI智能体的最佳方法——发布了一份关于这一转变的PDF研究报告。我将它粘贴到了Claude和GPT中,成本降低了约63倍。
以下是他们在44个基准测试中的发现:
1 → 7193个回答,10种失效类型。Jev针对幻觉、prompt注入、数据泄露和其他AI失效问题进行了测试。
2 → 一个简单问题就奏效:中位AUROC为0.886,无需针对特定任务训练,就在31个基准测试中的25个击败了训练过的基线模型。
3 → 上下文比巧妙的提示更有效——给Jev它需要的来源或规则,用来对照检查答案。
4 → 保留概率,而不只是“是”或“否”——在10个标注样本上拟合阈值将中位F1从0.706提升到了0.793。
5 → 在置信度最高的50%决策中,中位准确率达到0.933——将不确定的案例送去再次审核。
6 → Jev甚至帮助发现了三个基准测试中的标注错误。有时候测试的“正确答案”本身就是问题。
7 → 每次调用可以处理11.4个问题,中位延迟为0.31秒——在19个基准测试中,检查成本为0.30美元,而大语言模型裁判的成本是18.96美元,大约便宜63倍。
结果就是:它会让你的设置比95%的人正在用的方案更便宜、更快。复制研究人员在44个基准测试中测试过的Jev设置,然后阅读完整的Jev架构↓
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖