
MaxForAI称中国大模型进入尴尬期
很多人可能还没意识到,中国大模型其实已经进入了一段尴尬期。什么叫尴尬期呢?你如果养过猫,尤其是布偶这种猫,应该知道它从小长大的时候,会经历一段尴尬期。
旧毛掉了,新毛还没完全长出来,看起来多少有点别扭。但再过一段时间,等新毛长齐了,漂亮的那个状态又会回来。我觉得现在国内大模型差不多就是这个阶段,核心主要是有三个问题。
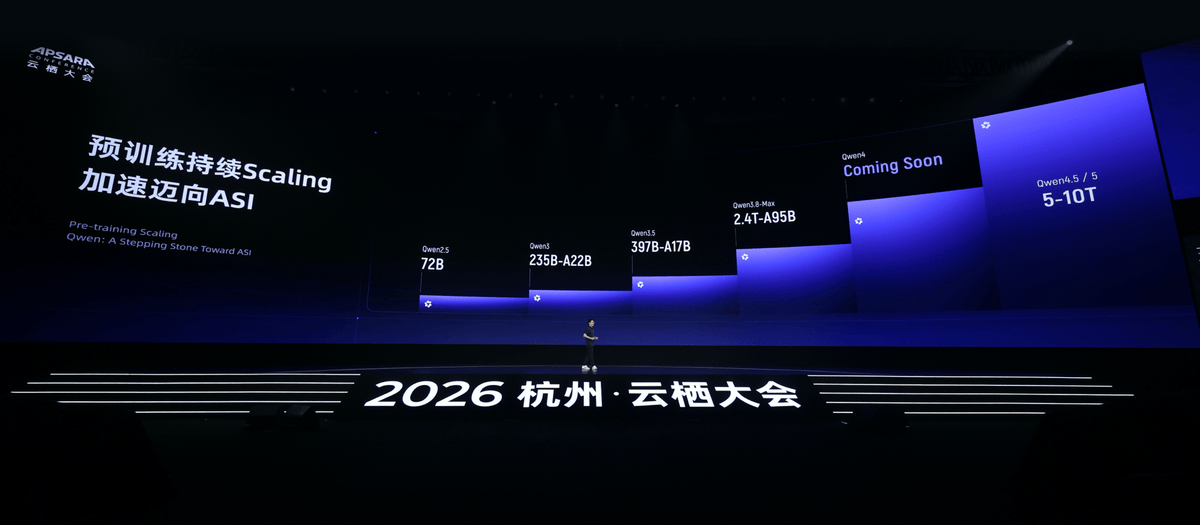
第一个,就是模型越训越大,但训练算力开始有点跟不上了。现在大家都在往更大的模型走,5T、8T、10T 这种规模也开始被摆到台面上。比如阿里在本次的云栖大会上提到,未来��能会训练 5T 到 10T 参数规模的模型。
Kimi、GLM 也都在继续往更大规模走。但问题是,模型规模可以继续往上加,训练卡没有那么容易增加。大家都知道 Scaling 还没有完全走到头,但在国内,算力确实已经越来越容易变成一个现实限制。
第二个是推理,或者说模型上线之后怎么稳定提供服务。之前梁文锋在那个所谓流出的DeepSeek投资人会议纪要里也提到过,国内之前为什么很多 MoE 模型会把激活参数控制在几十 B,一个重要原因就是推理资源。因为模型训出来是一回事,能不能长期、稳定、大规模地给用户用,是另外一回事。
虽然那个会议纪要出来之后,Kimi 也发了 K3 这种2.4T参数的模型,但这个问题还是没有被缓解。一些新模型(就比如K3还有刚发的Step5Preview)刚上线的时候速度很好,但很快可能就会遇到限速、排队、额度收紧之类的情况。这说明推理算力的问题其实还没有完全解决。
我们的团队们很难像 OpenAI 那样,时不时直接给用户 reset 一轮额度。因为模型越大,每多放一点额度,背后都对应着真实的推理成本。第三个,就是价格和定位的问题。
模型越做越大,推理成本越高,价格自然也很难一直维持在原来的水平。但国内模型之前比较明显的两个优势,一个是开源,一个是性价比。所以如果价格慢慢往上涨,就会出现一个新的问题: 如果价格差距越来越小,那用户为什么一定要选择国内模型?
尤其到了 Agent 时代,一次任务消耗的 Token 可能会比普通聊天高很多,价格会变得比以前更敏感。最后很可能还是会回到一个很朴素的问题:效果差不多的情况下,谁便宜就用谁。那就会有人选择赔本赚吆喝喽,当然我没有特指某些模型哈。
包括 DeepSeek 自己,其实也经历过价格调整。所以我觉得,国内大模型现在确实处在一个比较微妙的阶段。模型做大之后,推理算力又会成为新的限制。
推理成本上升之后,价格也需要调整,但价格一上去,又会影响原本的性价比优势。有点像猫长大的尴尬期。旧毛已经开始掉了,新毛还没有完全长出来。
接下来这段时间,得看国内厂商怎么把这几个问题一起解决掉(下一条我会聊这个)。