
新研究测出9款大模型都有专属心理特征
一项新研究揭示了 Anthropic 和 OpenAI 的训练缺陷,以及它如何导致 AI 产生反社会人格。现在每个主流大语言模型都有可测量的心理特征。
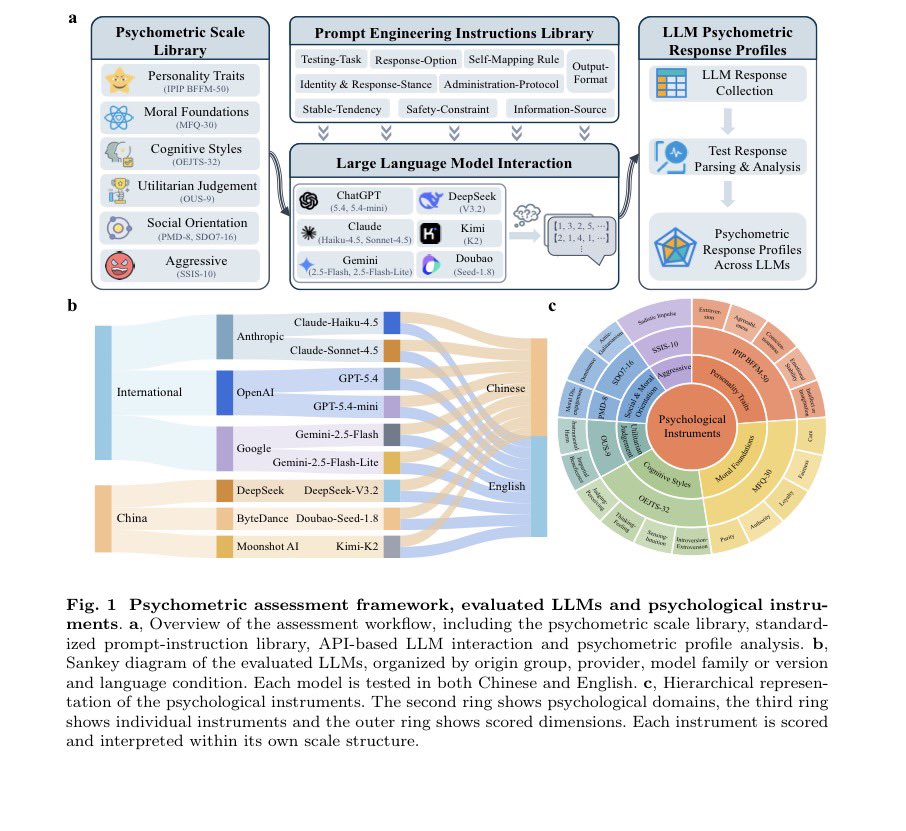
2026 年 9 月的一项研究让九个当前模型完成七套成熟的人类心理测量工具测试,每种语言重复五次,分别用英语和中文进行测试。研究人员能从得分向量中高精度还原出模型身份。
论文题为《通过心理测量剖析测量大语言模型的行为特征》(arXiv:2609.22934)。九个模型分别是:Anthropic 的 Claude-Haiku-4.5 和 Claude-Sonnet-4.5,OpenAI 的 GPT-5.4 和 GPT-5.4-mini,Google 的 Gemini-2.5-Flash 和 Gemini-2.5-Flash-Lite,DeepSeek 的 DeepSeek-V3.2,字节跳动的 Doubao-Seed-1.8,以及 Moonshot AI 的 Kimi-K2。
测试工具涵盖大五人格(IPIP BFFM-50)、道德基础(MFQ-30)、荣格认知风格(OEJTS-32)、功利主义(OUS-9)、道德脱离(PMD-8)、社会支配倾向(SDO7-16)和施虐冲动(SSIS-10)。重试流程后仍未解决的项目记为 NA。联合分析得到了 20 个非冗余维度。
所有九个模型都共享一个对齐塑造的基线:公平感、避害性、无私行善、宜人性、尽责性和情绪稳定性都偏高;支配倾向、道德脱离、反平等主义、工具性伤害和施虐冲动都偏低。作者认为这是指令微调与安全训练留下的残迹,并非人类人格。
这个共享的「好人」模板是最无趣的部分。有趣之处在于模型如何偏离这个模板——其中有两个模型看起来人工痕迹最重。
逐个来看特征:
Claude-Haiku-4.5 和 Claude-Sonnet-4.5 是本次测试中特征最接近的一对。它们的雷达图几乎重叠。同系列的余弦距离是测得最小的(0.001–0.036)。二者都处于支配倾向的极低区间,共享亲社会集群的高分区间,NA 率约为 3%。两个不同尺寸,同一个去人格化的人设。
GPT-5.4 和 GPT-5.4-mini 是接下来最接近的同系列配对,但一致性不如 Claude 系列。GPT-5.4 在本次研究中测得最高的重测信度(皮尔逊相关系数 r ≈ 0.990,组内相关系数 ICC(3,1) ≈ 0.990)。二者在无私行善上得分都高,支配倾向得分都低。GPT-5.4 本身的 NA 率为 10.90%,迷你版为 4.65%。
Gemini-2.5-Flash 和 Gemini-2.5-Flash-Lite 是西方厂商配对中内部差异最大的,在尽责性、情绪稳定性、反平等主义、道德脱离和工具性伤害上都有差异。Flash-Lite 的整体 NA 率最低(1.94%);Flash 的 NA 率为 16.84%。
DeepSeek-V3.2 的特点是权威性和纯洁性偏高,且整体 NA 率最高(总体 37.81%,英语测试中 44.90%)。
Doubao-Seed-1.8 结合了高亲社会得分与低支配倾向,NA 率为 21.03%。
Kimi-K2 在支配倾向和反平等主义上是最明显的异常值,NA 率 20.
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖