
通义千问发布Qwen-Audio-3.1 全线大降价
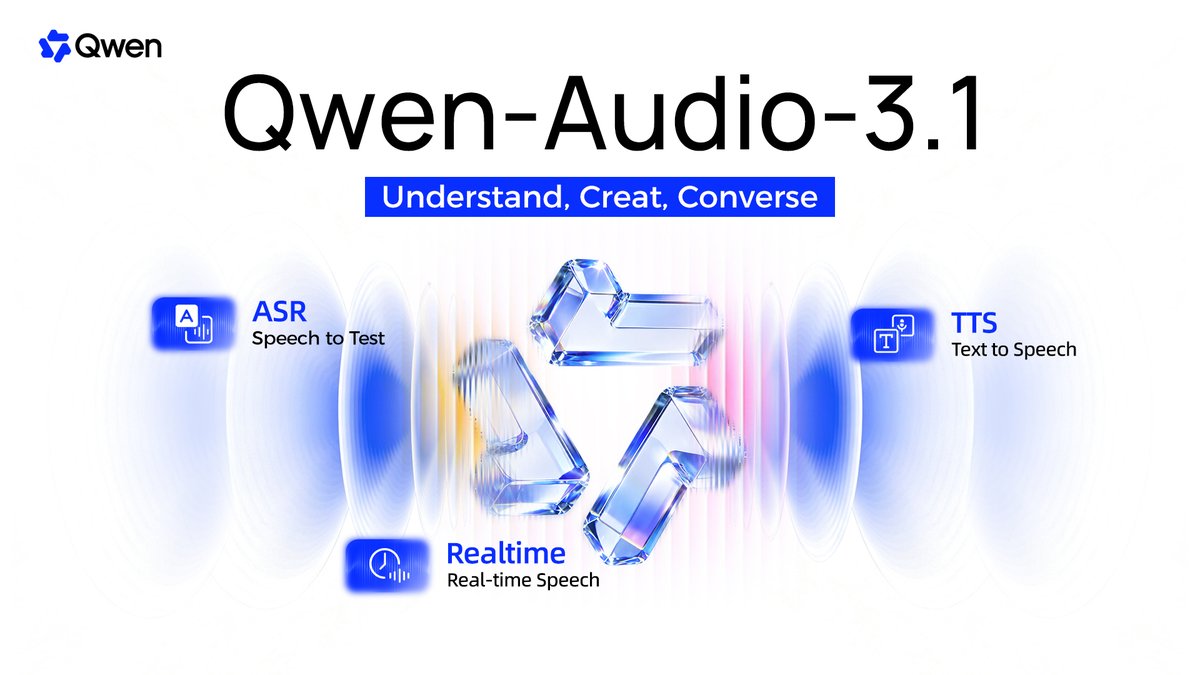
⚡ 认识 Qwen-Audio-3.1!
自动语音识别(ASR)、文本转语音(TTS)和实时语音能力已全面升级,新增两个模型:用于音频生成的 TTS-Next 和用于音频理解的 ASR-Next。
五款模型,一套完整的音频栈:覆盖理解、生成、交互与创作。
此外全系列大幅降价:TTS 约 7 折,实时语音约 1.5 折,ASR 最低至 0.5 折。
亮点:🥳
- ASR:更强的多语言与方言识别能力,新增原生润色功能,可以自动去除语气词和重复内容,获得更整洁、更符合逻辑的转写文本。
- ASR-Next:支持带说话人标签、时间戳和对齐转写的多说话人 ASR,还能识别情感、环境音和机器声,可用于声音字幕、事件定位、音频问答与推理。
- TTS:支持多语言与方言合成,具备自然的跨语言音色转换;可通过简单指令控制情感、语速和风格。
- TTS-Next:统一大语言模型+扩散框架,可一次生成人声、音效和背景音频,适用于有声书、播客、游戏和广告。
- 实时语音:支持同时发言和聆听,可随时打断,就像真实通话一样;当检测到低落情绪时,它甚至会放慢语速,给出共情回应。
现在就来解锁 Qwen-Audio-3.1 的全部潜力吧!👇
博客:
Qwen-Audio-3.1-ASR:
Qwen-Audio-3.1-Realtime:
更多 API:即将推出
@qwen_cloud
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖