
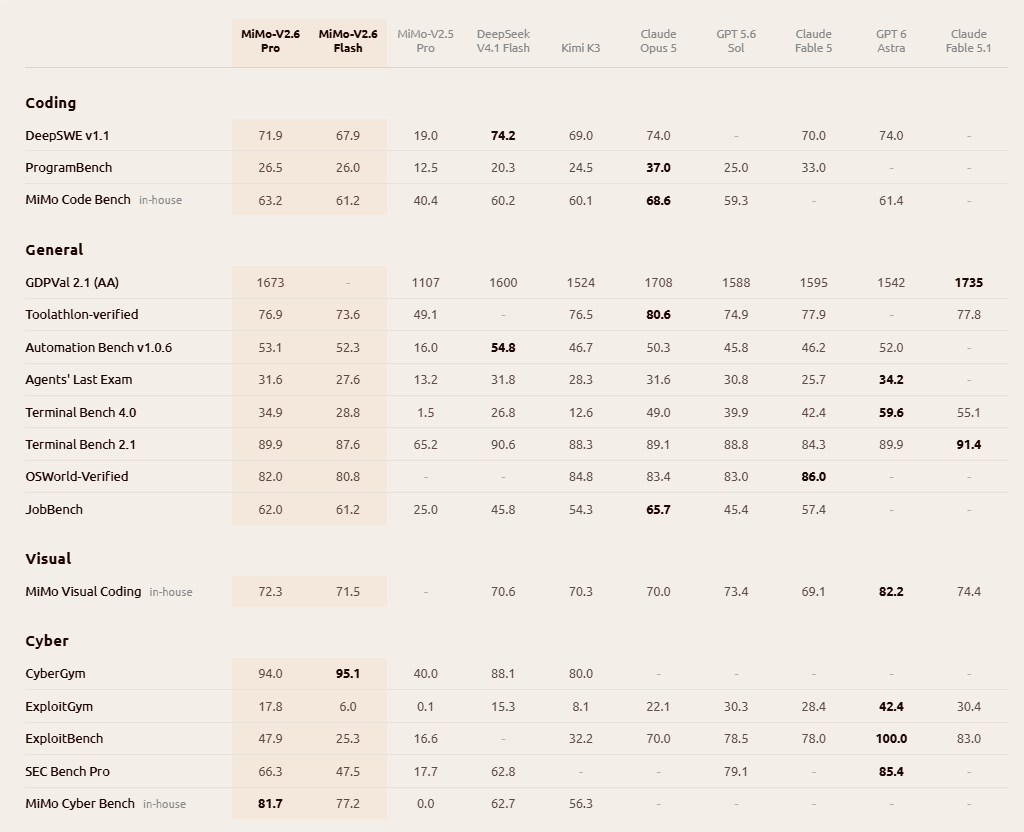
MiMo-V2.6 登顶第一开源大模型
MiMo-V2.6:强化学习扩缩的艰难之路
就计算量而言,MiMo-V2.6极有可能是迄今为止所有开源模型团队开展过的单次规模最大的强化学习训练之一。在算力极度稀缺的时代,我们仍然选择让几十人的团队长期专注于同一个目标:强化学习的规模扩展。这需要的不只是研究信念。它需要对通用人工智能的愿景、对未知的尊重,以及直面最难问题的勇气。最终得到的模型,它的潜力是在训练中期构建、通过大规模强化学习解锁的。现在,它是排名第一的开源模型。
我强烈推荐大家阅读这份技术报告。我相信它会成为强化学习智能体从业者每次重读都能有新发现的论文之一。在我看来,它背后的研究创新和工程挑战超过了我曾部分参与的DeepSeek R1。
有人会问:为什么用MixRL而不是MOPD?首先,它们不是二选一的竞争关系。我们在可验证的中等难度任务(包括代码和相关智能体任务)上运行了MixRL,发现最终得到的模型泛化能力非常出色。其次,难以验证、时间跨度极长或者难度过高不适合纳入联合强化学习训练的任务会单独训练,如果把它们包含进来会大幅降低回滚效率或者导致严重的回滚陈旧。我们随后通过MOPD融合得到的能力。游戏、3D任务和带有主观评估信号的任务都属于这一类。
还有第三个,有点调皮的答案。我们团队足够扁平化,几乎没有组织孤岛,所以对我们来说MixRL根本不难。更重要的是,大家都喜欢这么工作。来自不同领域的人每天聚在一起,在对通用人工智能和能够持续自我进化的智能的追求驱动下,直面并解决各个领域的强化学习瓶颈。我会永远记住这段时间里每天的强化学习进度例会。会议紧张充实,智能在实时涌现。
为了帮助开源社区专注于解决真正的强化学习智能体问题,我们发布了一个从MiMo强化学习轨迹蒸馏得到的通义千问模型,作为强化学习更强的起点,同时发布了7K个多样环境和一套完整的强化学习训练框架。我们希望这些资源能推动强化学习智能体研究向前发展。
MiMo-V2.6只是一个开始。在智能很容易复制的时代,我们仍然选择了通往自我提升和通用人工智能的艰难之路。前方大部分内容仍然未知。但我们愿意持续投入时间、算力和热情,一个接一个地攻克难题,把每个难题都坚持到底,直到智能跨入新的境界。
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖