
Da7_Tech发布Da7em Bench v0.1 基准测试(v0.1)
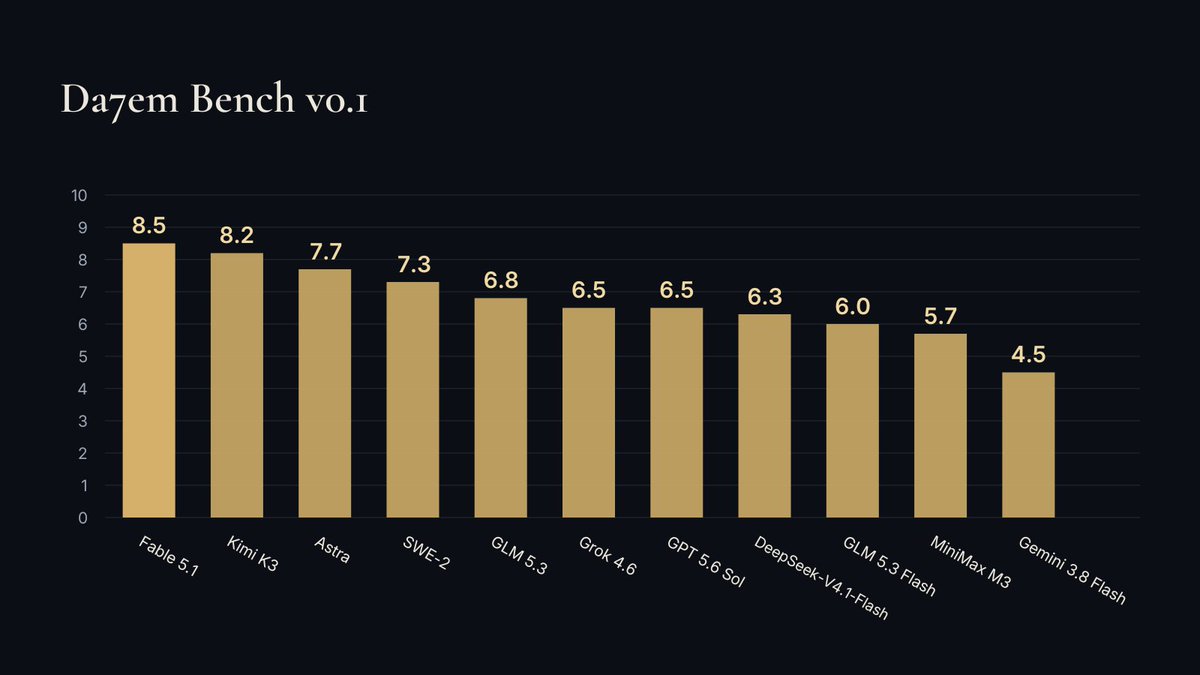
现在介绍 Da7em Bench。这是一个基于真实客户工作构建的 AI 模型独立基准测试,在全球范围内尚属首创。
它的运作方式:每个模型会在 12 个领域各完成大约 200 项真实任务,这 12 个领域是:推理、研究、规划、交付、持续性、准确性、诚实性、可接受性、工程、品味、写作和沟通。
每个模型会在多个测试环境中接受测试,包含官方和中立环境(Droid、Hermes Agent、Devin、Cursor),因此不会由单一测试环境决定模型的评价,结果能够如实反映模型本身的能力。
评分范围为 1 到 5。5 分意味着交付的工作直接通过验收。中等分数意味着工作需要修改。1 分意味着任务失败。评价标准是专业工作水平:每项结果都会和付费专业人员对同一任务的交付结果进行对比。
任务内容会保持私密,因此它们不会泄露到训练数据中,也不会导致未来评分虚高。
我们的目标不是再做一个排行榜,而是帮你为自己的工作类型挑选合适的模型。擅长推理的模型可能在写作或设计品味上表现不佳,而雷达图可以清晰展示模型在各领域的表现。
当前版本是 v0.1。未来它会持续进化,加入更难、更贴合市场需求的任务,也会在新模型发布后加入测试。
目前有几个热门模型(Opus 5、GPT Luna)还没有包含进来,因为我还没有完成足够多的任务来给出公平评分。
Da7em Bench 是完全独立的,没有赞助商,也不和任何厂商有关系。所有测试费用都是我自掏腰包,到目前为止已经花了数千美元。这就是它的核心意义:诚实、中立地看待这些模型在真实工作中的实际表现。
完整评分和框架见下方图片。
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖