
Jev 模型比现有大语言模型快40-200倍
看大家都在讨论Jev,一起来了解一下 这个模型的特点是由于它的构建模式决定的: 1、输出空间事先由 schema 定义 调用时你先声明“允许的答案是什么”,目前主要三类: - Choice:有限选项中选一个工单归类到 {退款, 技术故障, 投诉} - Score:数值/量表打分 比如 紧急程度 0–100 - Bool :是/否 + 概率 比如 这段输入是否含 prompt 注入?因为输出只能落在预定义集合里,所以“不会幻觉、不会类型错误”是结构上的必然 2、并行采样,非自回归 Jev 不是逐 token 生成的 transformer LLM,而是一次前向传播并行给出所有输出。这就是它延迟 70–500 ms(对比前沿 LLM 3–329 s)、快 40–200 倍的根源。
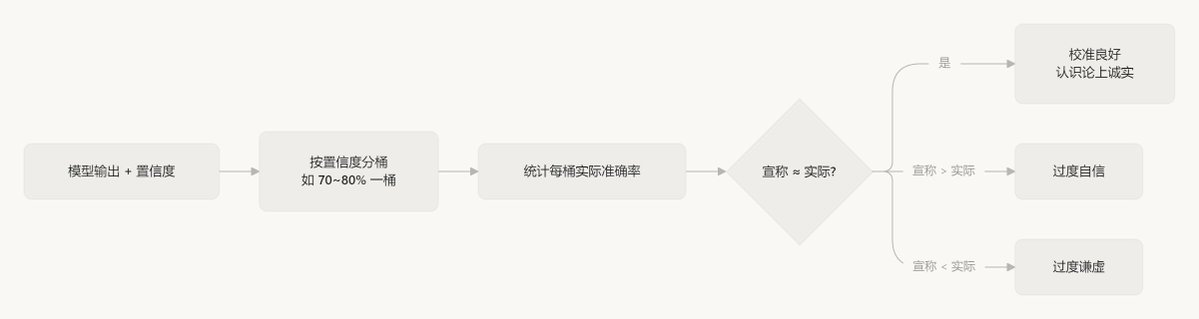
3、训练方法 RLCD(Reinforcement Learning for Calibrated Decisions) RLHF 优化“人类评分者喜欢的回答”; RLVR 优化“可验证的正确输出”; RLCD 优化“认识论上诚实的概率”——即模型说 80% 置信时,真实准确率就应接近 80%。这个校准很关键,因为模型输出的置信度可以直接当阈值用(比如 <0.7 就转人工)。具体逻辑可以看我贴的图 ----------- 理解了这个模型,那么不难识别,Jev有四个特别适合它特征的使用场景: 1、问题可枚举 2、量大或高频 3、对延迟/成本敏感 4、置信度能直接当阈值用。
满足其中三条就值得考虑使用Jev 我目前认为特别适合的一些场景: 1. 用户用自然语言写规则的“个人分类器” 过去个性化推荐需要训练排序模型,现在用户一句话“不看引战、不看币圈”就是一个分类器。可以推广到邮件分拣、通知优先级、评论区管理、家长控制、RSS/新闻聚合。2. 调用大模型之前的“前置门” 每个 Agent 循环里都有大量廉价判断被浪费在 LLM 上:这个请求要不要调 LLM、走哪个模型(便宜/贵)、要不要检索、检索回来的 chunk 相不相关、这轮工具调用成功没有、任务完成了吗、该不该停下来问用户。
把这些交给 Jev,LLM 只在真正需要生成时才被唤醒,整体成本和延迟能砍掉一大截。语义缓存的“命中判断”也属于这一类。3. 对结构化数据做“语义列” 比如:简历初筛(“有 3 年以上 Go 经验?
”)、合同条款存在性检查、电商评论的属性抽取(“是否提到尺码偏小”)、客服工单归因、问卷开放题编码、日志/告警的异常标注。特点是:一次性把整张表跑一遍,几分钟、几美元搞定,然后就能用 SQL 查了。4. 每个请求都要过的安全护栏 Prompt 注入检测、PII 检测、毒性判断、输出是否越权——这些必须在 100 ms 级完成、必须对每条请求都做、误判可以用置信度阈值分层处理(高置信直接拦,中间转人工)。
校准过的概率就非常有用。5. 大规模评测与标注 LLM-as-judge 现在的痛点是又贵又慢,做不到全量。Jev 可以对每条输出打分、比较 A/B 两个 prompt 的偏好、给训练数据打标签、监控线上模型质量。
它自己就是靠校准训练出来的,做 judge 的一致性比 LLM 更好。6. 实时交互和控制 AI玩游戏和交易机器人是这个方向的两端:游戏 NPC 的行为决策、直播弹幕的实时审核、客服对话中的情绪升级检测(该不该转人工)、机器人/IoT 的高层决策、根据用户操作动态调整 UI。共同点是决策必须跟上事件流的节奏。
7. 数据工程中的模糊匹配实体消歧(A 和 B 是不是同一家公司)、跨系统字段映射(这个列对应哪个标准字段)、去重、数据质量分级。这些传统上要么写规则要么训小模型,Jev 用自然语言描述规则就能上,而且能跑全量。