
前OpenAI团队成员推出Jev决策模型, 70ms输出仅需每百万token$0.042
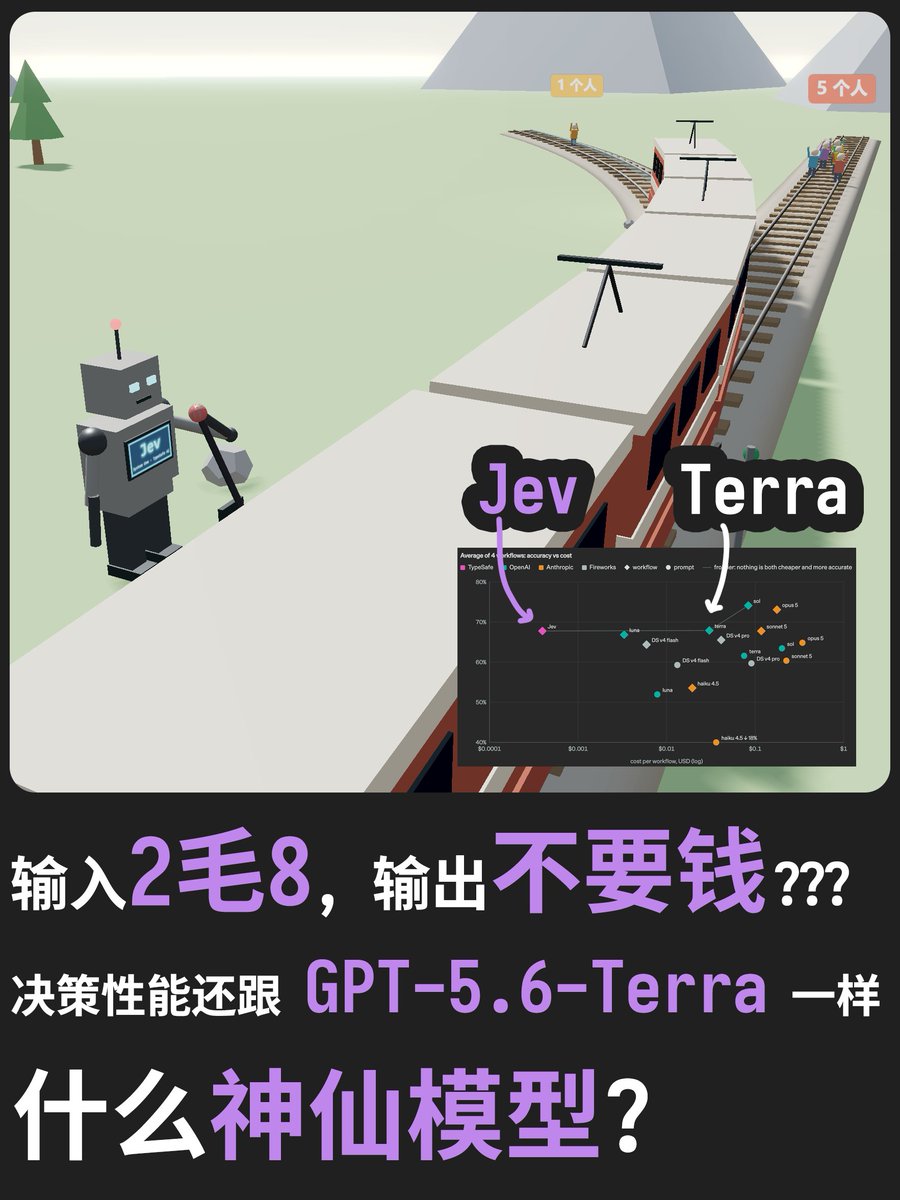
给大家写个简单的Jev模型介绍, 这绝对是个需要重点关注的模型。
简单讲, 这个模型放弃了传统自回归架构, 它没有办法直接输出普通文本。 但是他能进行决策! 比如最简单的二分类场景, 输入一条短信, 让它判断是否为垃圾短信, 它就可以输出这样的JSON: {"decision": { "isSpam": true }, "probabilities": { "isSpam": { "true": 0.982, "false": 0.018 } } }
没错, 它只能进行结构化输出, 甚至你输入的时候要定义 Schema (用过protobuf/GraphQL的同学应该能理解), 在送入模型时被编译为特定的决策槽位, 然后按照槽位输出, 所以输出JSON不可能出问题。 而复杂一些的场景, 比如让这个模型玩杀戮尖塔或者看盘, 只需要把内容转换为文本输入进去(没错, 目前模型只支持文本输入), 然后定义好模型能进行哪些动作, 模型就会自主决策了。
到目前为止, 是不是看上去跟普通文本大模型没区别? #jev #TypeSafeAI #DiogoAlmeida #systemone #vercel
但天下武功唯快不破, 这玩意从输入到输出最快只需要70ms! 所以完全可以用在高频的生产级场景, 比如接到堡垒机里面实时判断用户输入的shell命令是否存在危险(rm -rf /). 再加上输入每百万token只需要$0.042, 输出不要钱。 妥妥的新一代flash模型斩杀线(有的flash模型会被企业用作决策器).
说完了用途再来看它的架构, 传统大模型有多少token就要把激活参数过多少遍(前向传播)所以特别吃显存带宽, 而这个模型设计了一个特殊的并行采样架构, 只需要一次前向传播, 就能输出所有预设schema字段的离散预测与分支概率。 达成了极低的延迟。
而推出Jev的 TypeSafe AI 这个公司也很有噱头, 它是 Diogo Almeida 一手创办的, 就是他曾经在 OpenAI 的 InstructGPT 和早期 RLHF(基于人类反馈的强化学习) 团队中的贡献才有了如今的ChatGPT.
最后说一下目前模型的限制, 首先由于没有本土节点, 所以虽然它只需要70ms, 但是到美西这海底光缆延迟120ms是躲不掉的, 所以至少还是200ms打底。 另外, 模型被官方称为 System One 模型, 所以理想搭配还需要一个 System Two 模型用来进行战略判断, 然后生成策略当作提示词输入进去, 这样才能提升模型的输出质量。
另外, 官网还在申请使用, 不过vercel的AI Gateway已经能直接用了, 所以想测试的同学直接去vercel用就行。