
8.9B参数新模型改了逐字预测的老方式
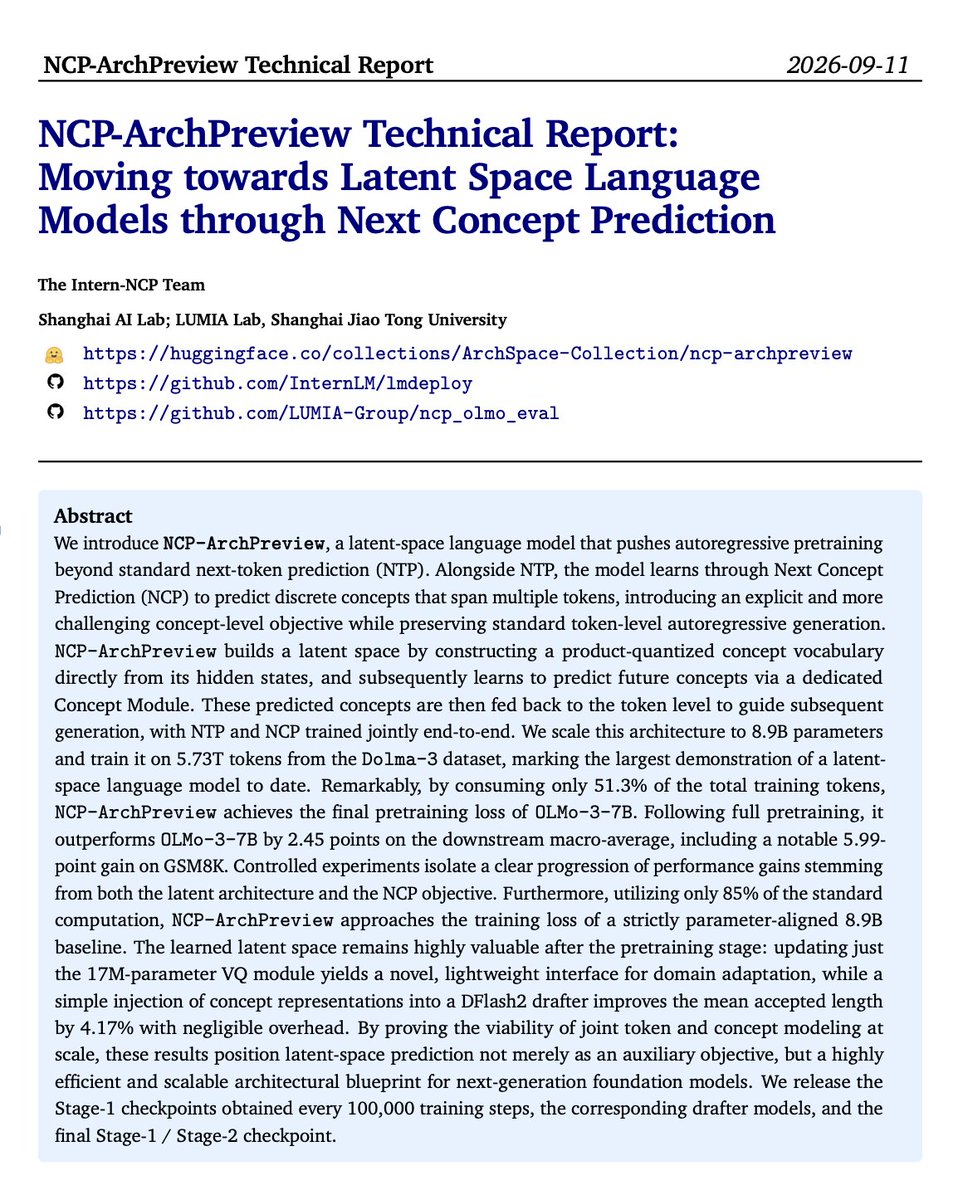
中国刚刚发表了一篇可能终结当前大语言模型时代的论文。他们开源了 NCP-ArchPreview,这是一个 89 亿参数、以概念思考而非逐词预测的模型。
你现在用的每一个 AI 本质上都是在玩一个大型自动补全游戏。ChatGPT、Claude、Gemini,它们生成答案的方式完全一样。一个词,一个词,逐个生成。
这叫下一个词预测,这种方式效率极低。因为人类不是用单个词思考的,我们用概念思考。
现在,上海的一个团队刚刚证明他们可以教会 AI 做和人类一样的事。他们发表了一篇论文介绍 NCP,即下一个概念预测。
这种新架构不是盲目猜测下一个词,而是构建了一个隐藏的“潜在空间”,它将信息分组为更大、离散的概念。模型先预测概念,再用这个基础概念来引导实际输出的词语。
这个结果改写了AI训练的经济性。他们用这种新方法构建了一个 89 亿参数的模型,只用 51.3% 的训练数据,就达到了和最先进开源模型完全相同的基准智能水平。它只用一半的 token 就达到了完全收敛。
完全训练后,它击败了标准模型,在复杂数学和推理任务中得分大幅提升了 6 分。而且做到这一点只需要比标准模型少 15% 的计算量。
过去三年,我们一直是通过给模型投喂数万亿个单词来蛮力提升智能。但 AI 的未来不在于预测下一个 token,而在于在想法被说出之前就理解它。
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖