
历时六个月完成的AI智能体训练系列课已全部开源
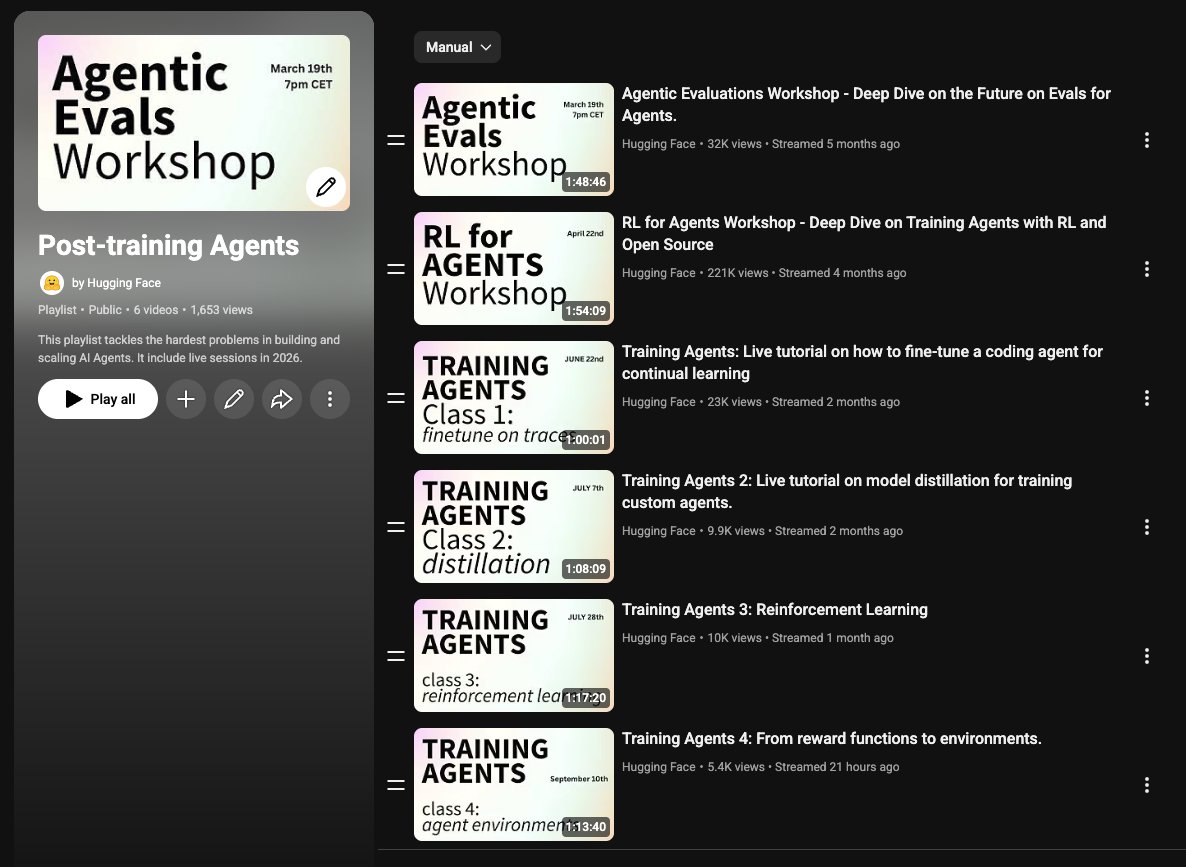
我们完成了Training Agents系列。六个月里举办了六场线上直播,从评估智能体到在真实环境中训练它们。所有内容都在 Hugging Face 的 YouTube 频道,所有代码都已开源。以下是我们做的内容以及参与者:
1. 智能体评估工作坊:讨论目前智能体评估的实际状况,以及为什么基准分数与人们实际使用中看到的情况不匹配。参与者包括 Hugging Face 的Avijit Ghosh和Nathan Habib、普林斯顿大学的Arvind Narayanan、Meta的Pierre Andrews、英国人工智能安全研究所的J.J. Allaire,以及Bespoke Labs的Mahesh Sathiamoorthy。
2. 智能体强化学习工作坊:讨论环境、推出、奖励设计,以及当你从大语言模型强化学习转向智能体强化学习时出现的推理瓶颈。参与者包括 Hugging Face 的Lewis Tunstall、Prime Intellect 的Will Brown、普林斯顿大学的Ofir Press 和 MIT CSAIL 的Alex Zhang。
3. 训练智能体 1:基于智能体轨迹的监督微调(SFT):将公开的编码智能体轨迹转换为提示/补全数据,在 Hugging Face Jobs 上使用 TRL + LoRA 进行微调,在 Trackio 中查看指标,并且坦诚分析第一次评估数据能说明什么、不能说明什么。参与者是 Sergio Paniego 和 Quentin Gallouédec。
4. 训练智能体 2:蒸馏:离策略、同策略和自蒸馏,用于将能力从教师模型迁移到更小的编码智能体。
5. 训练智能体 3:强化学习:监督微调后使用 GRPO:分组采样、可验证奖励函数、解读奖励/KL/长度曲线,以及三个实验,其中一个实验特意使用了可被利用的奖励,以便我们观察“奖励黑客”现象。
6. 训练智能体 4:从奖励函数到环境:奖励不再是一个函数,而是变成了智能体行动的场所。我们讲解了从 Gym 到大语言模型智能体的 reset()/step() 约定,构建了一个 OpenEnv 环境并推送到 Hub,将它接入 TRL 的 GRPOTrainer,然后在 Hugging Face 沙箱上通过 Harbor 使用 AsyncGRPOTrainer 训练了一个真正的编码智能体(OpenCode)。
该系列的观看量已经超过 30 万次。感谢每位讲者、TRL 团队,以及所有来到直播间提问的观众。播放列表:
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖