
国产大模型代码测试,DeepSeek拿下第一
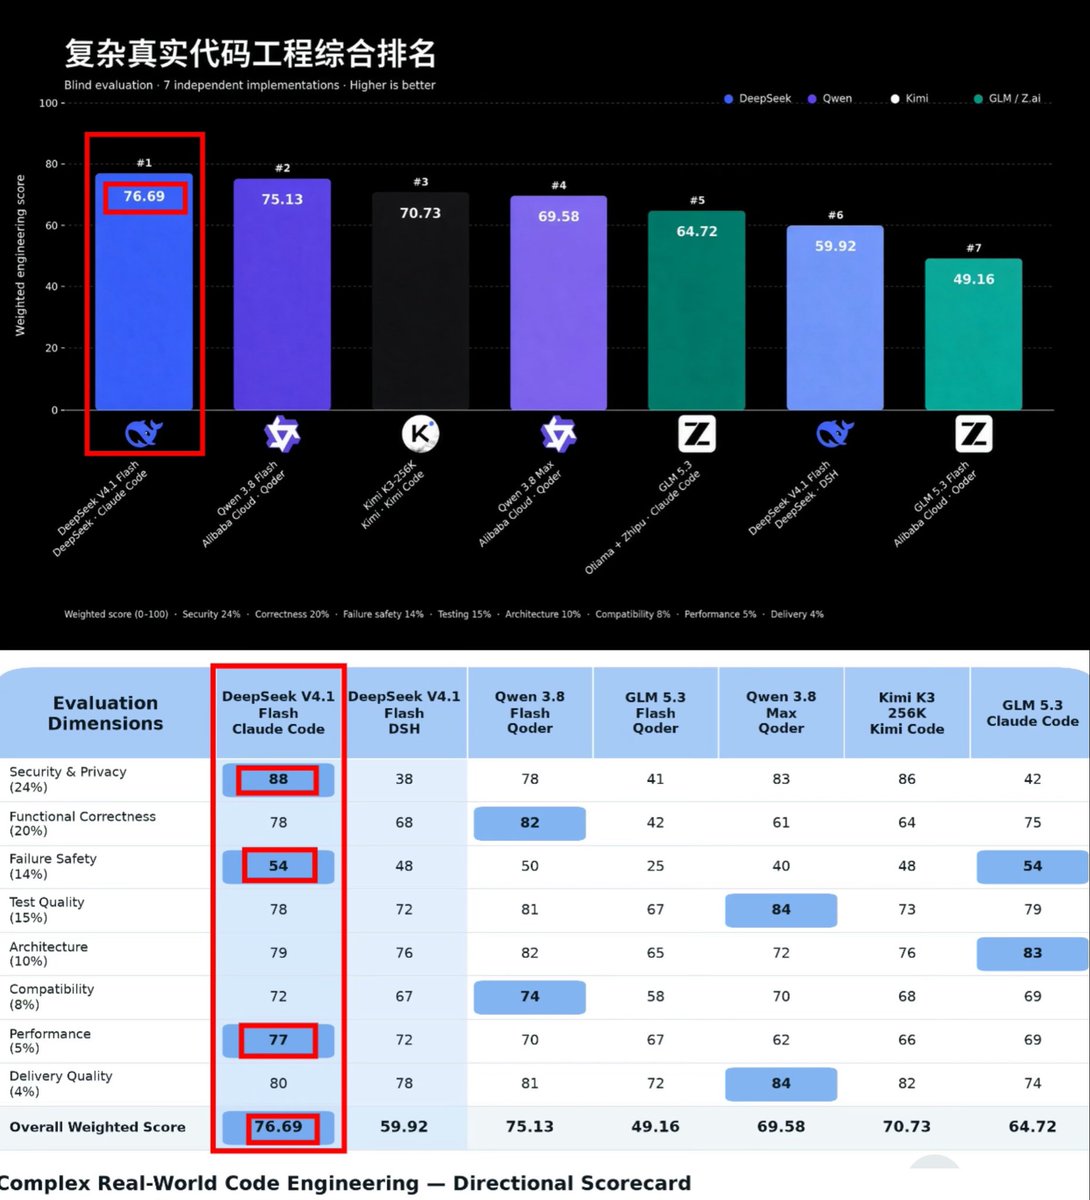
💥内测版DeepSeek V4.1 Flash在真实生产级代码工程里拿下国产模型第一,但短板同样清楚!
7组“模型+编程客户端”同题盲测:同一份代码、同一生产级安全问题、完全隔离沙盒,最终结果如下:
1️⃣DeepSeek V4.1 Flash + Claude Code 76.69
2️⃣Qwen 3.8 Flash 75.13
3️⃣Kimi K3-256K 70.73
4️⃣Qwen 3.8 Max 69.58
5️⃣GLM 5.3 64.72
6️⃣DeepSeek V4.1 Flash + DSH 59.92
7️⃣GLM 5.3 Flash 49.16
🔹它赢在哪:安全隐私 88、失败/并发安全与性能拿最高分,缓存命中率全程 99%+,49 分钟跑完,比大参数模型快一截。
🔹它输在哪,也很硬:
▫️宿主环境把分数打穿:换 DSH 直接掉 16.77 分,工具接入、上下文组织、执行流程还不够稳。
▫️功能正确性 78,输给 Qwen 3.8 Flash 的 82。
▫️测试质量、架构、兼容性、交付都不是单项第一。
▫️失败安全绝对分只有 54,事务、并发和失败路径仍有明显提升空间。
▫️这只是单任务工程评测,不等于通用能力排名。
结论:Flash 已经能打旗舰,但模型本身还没把工程边角打满,客户端更是当前最大变量,Flash道阻且长!
#DeepSeek #V41Flash #国产大模型 #AI编程 #ClaudeCode #Qwen #Kimi #GLM